فهرست مطالب
گوگل Gemini 3.8 Live و Extended Thinking را با گفتوگوی صوتی بلادرنگ، پشتیبانی از ۹۷ زبان و استدلال چندمرحلهای معرفی کرد.
به گزارش سرویس هوش مصنوعی تکناک،تام اویانگ، مهندس ارشد گوگل، و مالینی جاگاناثان، عضو تیم فنی، این مدلها را از طرف تیم Gemini Audio معرفی کردند.
گوگل میگوید این دو مدل پیشرفتهترین مدلهای گفتوگوی زنده این شرکت هستند و برای مکالمات طبیعی طراحی شدهاند.
به گفته گوگل، افزایش توانایی هوش مصنوعی و قابلیت استدلال موازی باعث شده است تعامل صوتی با این مدلها برای انجام کارهای پیچیده، طبیعیتر و سادهتر باشد.
گوگل مدل Gemini 3.8 Live را برای استفاده گسترده و مقرونبهصرفه طراحی کرده است. این مدل، هوش مکالمهای را با گفتوگوی روان و درک محتوای بصری ترکیب میکند.
در مقابل، Gemini 3.8 Live Extended Thinking برای وظایف پیچیدهای ساخته شده است که به توانایی بیشتر و استدلال چندمرحلهای نیاز دارند.
نتایج بنچمارکهای اعلامشده
گوگل اعلام کرده است که Gemini 3.8 Live Extended Thinking در شاخص Speech to Speech Quality Index متعلق به Artificial Analysis با امتیاز ۸۲.۶ در جایگاه نخست قرار گرفته است.
این مدل همچنین در تکمیل وظایف عاملمحور، در بنچمارک τ-Voice امتیاز ۶۸.۶ درصد و در آزمون بانکی Sierra با نام τ-Voice-banking امتیاز ۳۵.۱ درصد را به دست آورده است.
گوگل همچنین امتیاز ۹۷.۷ درصدی این مدل را در Big Bench Audio اعلام کرده و میگوید Extended Thinking در مقایسه با سایر مدلهای پیشرفته، قیمت رقابتی دارد.
Gemini 3.8 Live نیز در Speech Agent Arena متعلق به Artificial Analysis در جایگاه دوم قرار گرفته است.
گوگل میگوید کاربران استقبال زیادی از این مدل داشتهاند و آن را گزینهای مقرونبهصرفه برای استفاده گسترده میداند.
در بنچمارک EVA-Bench شرکت ServiceNow که برای ارزیابی عاملهای صوتی استفاده میشود، گوگل میگوید مدلهای جدید توانستهاند در کارهای پیچیده، میان دقت و کیفیت مکالمه تعادل ایجاد کنند.
این ارزیابی با استفاده از Live API در پلتفرم Gemini Enterprise Agent Platform انجام شده است.
بیشتر بخوانید: گوگل اپلیکیشن اختصاصی Gemini را برای ویندوز منتشر کرد
مکالمه همزمان و استدلال عمیقتر
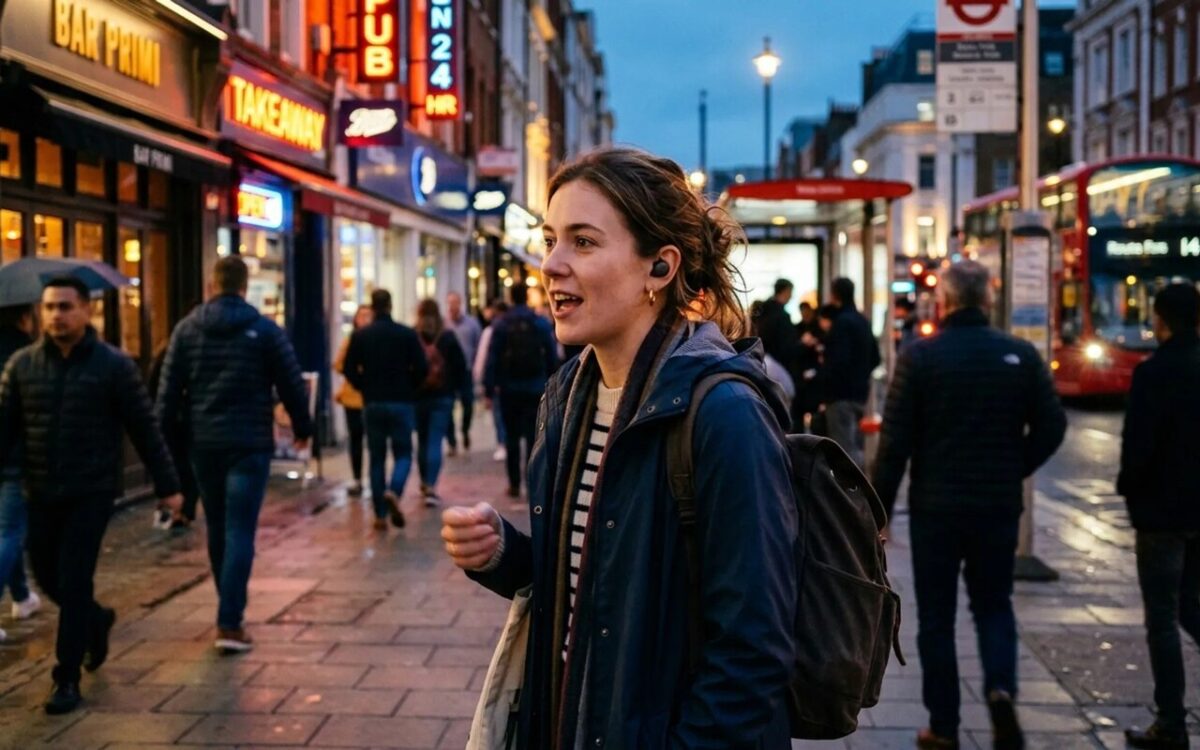
به گفته گوگل، Gemini 3.8 Live ورودیهای بصری را تقریباً بهصورت همزمان پردازش میکند و از این اطلاعات برای ارائه پاسخهای مرتبطتر استفاده میکند.
این مدل میتواند ۹۷ زبان پشتیبانیشده را در میانه مکالمه بهصورت خودکار تشخیص دهد و میان آنها جابهجا شود.
Gemini 3.8 Live همچنین میتواند هنگام ادامه مکالمه، ابزارها و فراخوانیهای API را در پسزمینه اجرا کند.
مدل در این شرایط درخواست کاربر را تأیید میکند و گفتوگو را ادامه میدهد تا وظیفه موردنظر در پسزمینه تکمیل شود.
در وظایفی که به استدلال عمیقتر نیاز دارند، Extended Thinking میتواند همزمان با استدلال، صحبت کند.
این مدل از پاسخهای صوتی اولیه برای تأیید طبیعی درخواست استفاده میکند و با توضیح زنده روند پیشرفت، کاربر را در جریان انجام وظایف چندمرحلهای قرار میدهد.
بیشتر بخوانید: حذف چتهای Gemini همیشه به معنای پاکشدن آنها نیست
قابلیتهای جدید برای توسعهدهندگان
گوگل در نمونههای نمایشی خود نشان داده است که Gemini 3.8 Live میتواند در یک جلسه آموزش کارکنان، با استفاده از اطلاعات بصری به پرسشها پاسخ دهد، در زمان نزدیک به واقعی شطرنج بازی کند و با دریافت دستورهای صوتی، برنامههای تجاری و ابزارهای بازاریابی اختصاصی بسازد.
Extended Thinking نیز در نمونههای نمایشی برای تبدیل طرحهای اولیه و بازخورد صوتی تقریباً همزمان به کامپوننتهای کاربردی React استفاده شده است.
این مدل همچنین میتواند رزرو چندمرحلهای رستوران را با استفاده از فراخوانیهای غیرهمزمان انجام دهد، بدون اینکه مکالمه را متوقف کند.
نمونههای دیگری نیز استفاده از این مدل در Docs Live، Gmail Live و Keep Live را نشان میدهند.
گوگل اعلام کرده است که پلتفرمهای Agora، Fishjam، LiveKit، Pipecat، Vercel و Vision Agents از Gemini Live API برای ساخت رابطهای صوتی استفاده میکنند.
این پلتفرمها زیرساخت پخش رسانهای بلادرنگ را مدیریت میکنند و توسعهدهندگان میتوانند روی ساخت رابطهای صوتی تمرکز کنند.
کاربردهای گسترده Live API
مستندات رسمی Live API این رابط را برای تعاملات صوتی و بصری کمتأخیر و بلادرنگ با Gemini معرفی میکنند.
این API جریانهای مداوم صدا، تصویر و متن را پردازش میکند و پاسخهای صوتی فوری را از طریق اتصال WebSocket حالتمند ارائه میدهد.
ورودی صوتی این رابط، صدای خام ۱۶ بیتی PCM با نرخ ۱۶ کیلوهرتز است و تصاویر JPEG نیز با حداکثر یک فریم در ثانیه دریافت میشوند.
خروجی صوتی با فرمت خام ۱۶ بیتی PCM و نرخ ۲۴ کیلوهرتز ارائه میشود.
توسعهدهندگان میتوانند از معماری سرور به سرور استفاده کنند که در آن یک بکاند دادههای جریان کاربر را به Live API منتقل میکند.
گزینه دیگر، معماری کلاینت به سرور است که در آن کد بخش فرانتاند مستقیماً از طریق WebSocket به API متصل میشود.
گوگل کاربردهای این فناوری را در دستیارهای خرید و پشتیبانی، شخصیتهای تعاملی بازیها، رباتیک، عینکهای هوشمند، خودروها، همراههای صوتی سلامت، ابزارهای مشاوره مالی، آموزش، ترجمه همزمان و رونویسی و زیرنویس زنده معرفی کرده است.
گوگل همچنین میگوید تمام صداهای تولیدشده توسط محصولات هوش مصنوعی این شرکت با SynthID واترمارک میشوند.
این واترمارک نامرئی مستقیماً در خروجی صوتی قرار میگیرد تا امکان شناسایی محتوای تولیدشده با هوش مصنوعی فراهم شود و از انتشار اطلاعات نادرست جلوگیری شود.
زمان عرضه Gemini 3.8 Live
عرضه هر دو مدل از ۱۵ سپتامبر آغاز شده است. توسعهدهندگان میتوانند از آنها در Gemini API و Google AI Studio استفاده کنند.
این مدلها برای کاربران سازمانی نیز در قالب پیشنمایش خصوصی Gemini Enterprise در دسترس قرار گرفتهاند.
Gemini 3.8 Live برای همه کاربران Search Live فعال شده است. Extended Thinking نیز در Gemini Live و در بخش Docs برای مشترکان Google AI Pro و Ultra از طریق Workspace در دسترس است.
این مدل در Gmail و Keep نیز برای تمام مشترکان Google AI ارائه میشود.
گوگل اعلام کرده است پشتیبانی از هر دو مدل در Gemini Enterprise برای بخش خدمات مشتریان بهزودی ارائه خواهد شد.
Extended Thinking نیز در آینده نزدیک برای مشتریان تجاری Google Workspace در دسترس قرار میگیرد.