فهرست مطالب
بنچمارک Vulsar AI با بررسی ۲۴ مدل زبانی و ۴۷۵ پرامپت نشان داد مدلهای پیشرفته از نویسندگان آماتور پیشی گرفتهاند، اما نه از حرفهایها.
به گزارش سرویس هوش مصنوعی تکناک، با گسترش هوش مصنوعی، گزارشهای مختلفی درباره احتمال جایگزینی مشاغل مرتبط با نویسندگی با مدلهای پیشرفتهتر هوش مصنوعی منتشر شده است.
با این حال، نتایج این بنچمارک که بر اساس ۴۷۵ پرامپت انجام شده، نشان میدهد فقط مدلهای پیشرفته هوش مصنوعی توانستهاند از نویسندگان انسانی پیشی بگیرند، آن هم از نویسندگان آماتور، نه حرفهای.
GPT-6 Astra در صدر جدول عملکرد کلی قرار گرفت
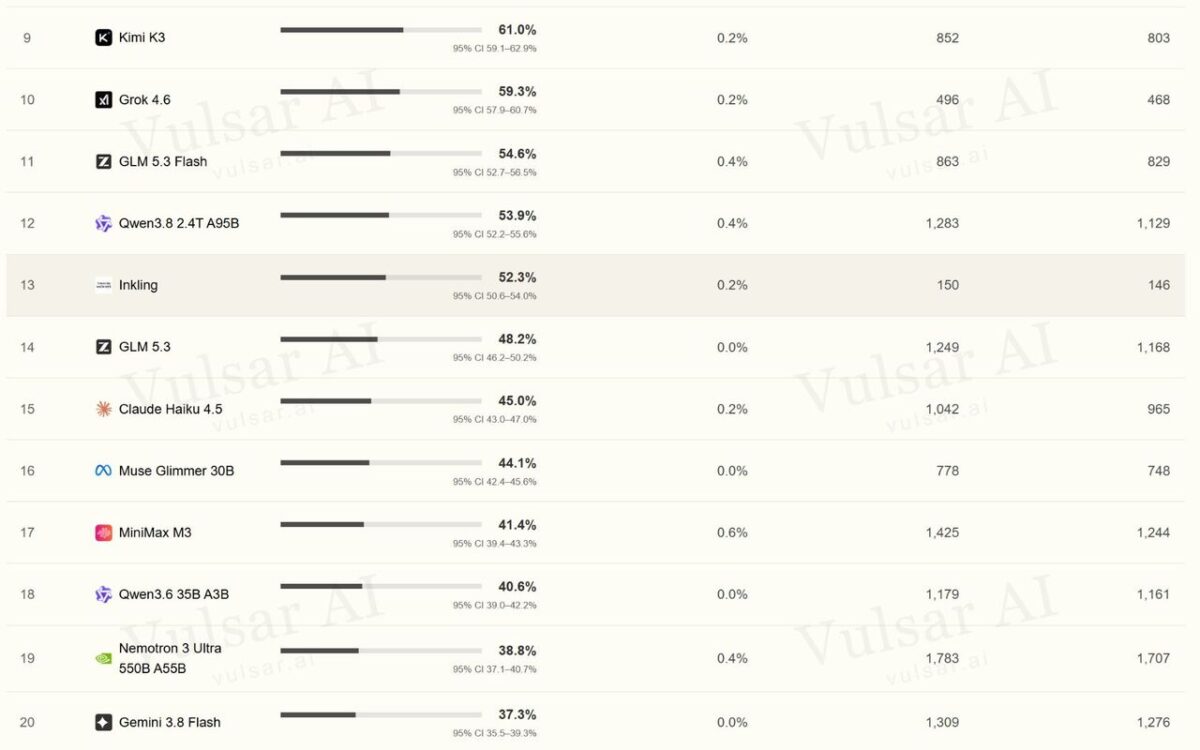
بنچمارک Vulsar AI جایگاه مدلهای زبانی بزرگ را در تولید متنهای بلند ارزیابی میکند. در این آزمون، از یک مدل پاداش استفاده شده که با دادههای ترجیحات انسانی تنظیم دقیق شده است تا میزان ترجیح کلی خوانندگان را پیشبینی کند.
بر اساس جدولهای رتبهبندی موجود در تصاویر گزارش، GPT-6 Astra با نرخ برد پیشبینیشده ۸۷.۸ درصد در صدر قرار گرفته و اندکی از نویسندگان انسانی با نرخ برد ۸۶.۶ درصدی پیشی گرفته است.
با این حال، فاصله مهارتی میان نویسندگان آماتور و حرفهای بسیار زیاد است.
نتایج آزمون نشان میدهد مدلهای پیشرفتهای مانند GPT-6 Astra توانستهاند از نویسندگان آماتور پیشی بگیرند، اما نویسندگان حرفهای در ارزیابی جداگانه همچنان امتیاز بهمراتب بالاتری کسب میکنند.
در رتبه سوم، مدل GPT-5.6 Sol شرکت OpenAI با نرخ برد پیشبینیشده ۷۷.۶ درصد قرار دارد. مدل Claude Fable 5.1 شرکت Anthropic نیز به نرخ برد ۷۰.۳ درصدی رسیده است.
با این حال، پس از عبور از مدلهای هوش مصنوعی دارای چندین تریلیون پارامتر، امتیازها بهشدت کاهش پیدا میکنند.
برای مثال، مدلهایی مانند Claude Opus 5، Kimi K3 و Grok 4.6 در محدوده ۵۰ تا ۶۵ درصد قرار گرفتهاند.
این نتایج نشان میدهد حتی مدلهای مطرح هوش مصنوعی نیز با محدودیتهایی روبهرو هستند و عملکرد آنها در مقایسه با معیارهای انسانی یکسان نیست.
مدلهای کوچکتر و کمتراکمتر نتایج ضعیفتری ثبت کردهاند. مدل Qwen3.8-27B به امتیاز ۲۳.۲ درصدی رسیده و DeepSeek V4.1 Flash نیز امتیاز ۱۹.۸ درصدی کسب کرده است.
مدل Gemma 4 26B با امتیاز تنها ۱۰.۹ درصد، در انتهای جدول قرار گرفته است.
بیشتر بخوانید: جایگزین آفلاین و رایگان فتوشاپ با GPT-6 Astra ساخته شد
نویسندگان انسانی در تولید متن و حفظ انسجام برتری دارند
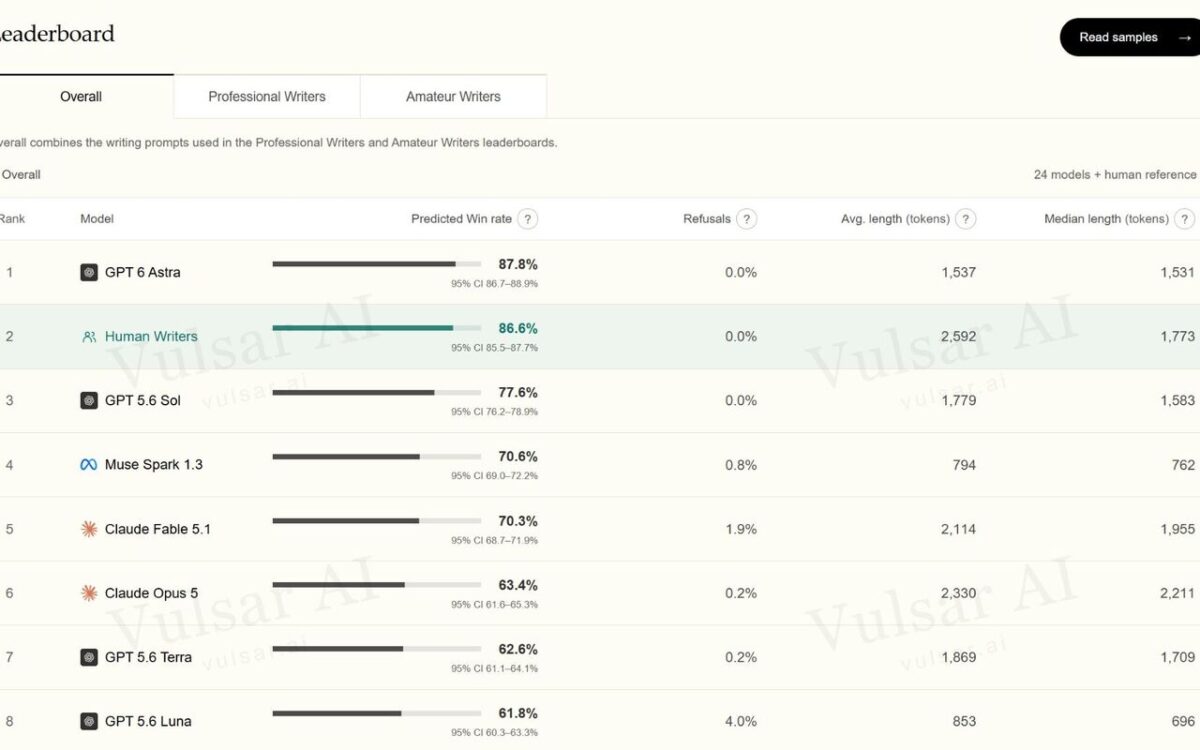
از نظر تعداد توکنهای تولیدشده، نویسندگان انسانی با میانگین ۲۵۹۲ توکن برای هر پرامپت بیشترین خروجی را ثبت کردهاند.
پس از آن، مدلهایی مانند Claude Fable 5.1 با ۲۱۱۴ توکن و GPT-6 Astra با ۱۵۳۷ توکن قرار گرفتهاند.
بحثهای کاربران در ردیت نیز به یکی از محدودیتهای مهم مدلهای کوچکتر اشاره میکند.
این مدلها هنگام مواجهه با پرامپتهایی که چندین فصل را در بر میگیرند، اغلب انسجام روایت را از دست میدهند و عبارتهای تکراری تولید میکنند.
به همین دلیل، نویسندگان انسانی در این زمینه همچنان برتر دانسته میشوند.
نویسندگان انسانی نهتنها میتوانند داستانهای پیچیده را با انسجام بیشتری پیش ببرند، بلکه با تکیه بر تفکر خودجوش، قادرند سبک و سرعت نوشتنشان را نیز در لحظه تغییر دهند.
با این حال، این پرسش همچنان مطرح است که چه مدت طول میکشد تا مدلهای زبانی بزرگ بتوانند تقریباً همان کیفیتی را ارائه دهند که نویسندگان حرفهای تولید میکنند. بررسی این موضوع به بحثی جداگانه نیاز دارد.
بیشتر بخوانید: تقاضای بالا برای Astra؛ OpenAI اشتراک ۲۰۰ دلاری پرو را متوقف کرد