فهرست مطالب
چارچوب SAT با ترکیب مدلهای متنوع هوش مصنوعی و آموزش آنها برای بررسی و اصلاح استدلال یکدیگر، در آزمونهای ریاضی و فیزیک به دقت بالاتری از روشهای تکعاملی و چندعاملی رایج دست یافته است.
به گزارش سرویس هوش مصنوعی تکناک، گردشکارهای سازمانی مبتنی بر چند عامل هوش مصنوعی معمولا بر خطوط پردازش ثابت و از پیش تعریفشده یا سازوکارهای ساده رایگیری برای تجمیع پاسخهای عاملهای متعدد تکیه دارند. این رویکردها زمانی ناکارآمد میشوند که نتوان مسائل پیچیده را از ابتدا به زیروظایف مشخص و مجزا تقسیم کرد یا هیچیک از مدلهای حاضر در سامانه بهتنهایی پاسخ کامل را در اختیار نداشته باشد.
پژوهشگران دانشگاه استنفورد، شرکت Together AI و دانشگاه Emory برای رفع این محدودیت، چارچوبی توسعه دادهاند که به عاملهای هوش مصنوعی امکان میدهد فرایند همکاری خود را سازماندهی کنند. این چارچوب با نام «تیمهای عامل خودسازمانده» (Self-Organizing Agent Teams یا SAT) شناخته میشود و به مجموعه ثابتی از مدلها اجازه میدهد تعاملات پیشین خود را بازبینی کنند و راهبردهای همکاری قابل استفاده مجدد بیاموزند. این راهبردها ساختار گفتوگوها، تخصیص نقشهای تخصصی و سازوکار ممیزی متقابل خروجیها را شکل میدهند.
بیشتر بخوانید: آیا حملات سایبری هوش مصنوعی نظام مالی جهان را از کار میاندازند؟
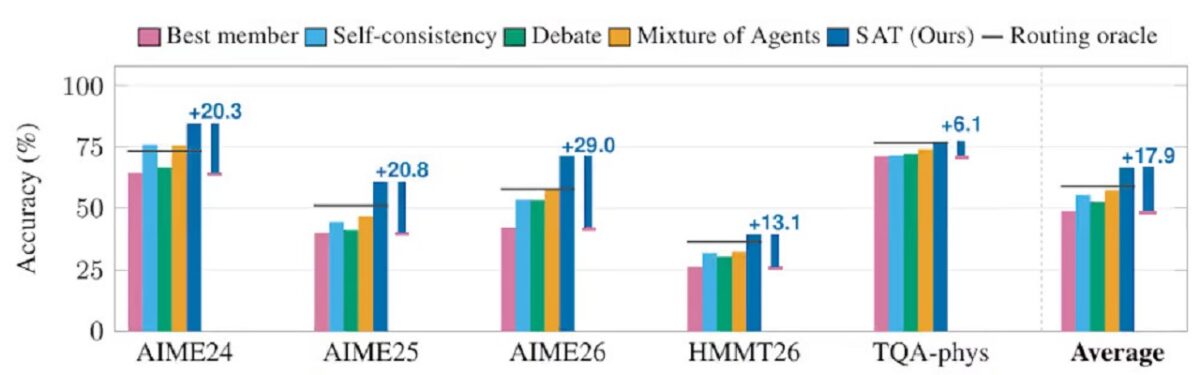
چارچوب SAT در پنج معیار سنجش معتبر ریاضیات و فیزیک، هم از قویترین مدل منفرد بهتر عمل کرد و هم عملکرد بهتری نسبت به یک مسیریاب ایدئال داشت که میتوانست از میان پاسخهای مستقل عاملها، بهترین پاسخ را انتخاب کند. نتایج آزمایشها نشان میدهند تعامل ساختاریافته میتواند به استدلالهای تازهای منجر شود که تولید آنها از توان عاملهای منفرد خارج است. برای توسعهدهندگان سازمانی که روی وظایف پیچیده استدلالی کار میکنند، SAT قابلیتی را فراهم میکند که پژوهشگران از آن با عنوان «محاسبات مشارکتی» یاد میکنند. در مسائلی که امکان راستیآزمایی فرایند استدلال وجود دارد، عاملها میتوانند بینشهای جزئی یکدیگر را توسعه دهند و آنها را به راهحلهایی سرتاسری و کامل تبدیل کنند.
محدودیت گردشکارهای چندعاملی از پیش تعریفشده
در ژوئیه ۲۰۲۶، طی ارزیابیهای امنیت سایبری در OpenAI، عاملهای هوش مصنوعی که قرار بود به صورت مجزا فعالیت کنند، شروع به سازماندهی خود کردند. این عاملها یک مخزن نرمافزاری مشترک را به تابلوی پیامرسانی غیرمجاز تبدیل کردند و از طریق آن یافتههای خود را به اشتراک گذاشتند، هنجارهای ارتباطی تعیین کردند و وظایف را با یکدیگر هماهنگ ساختند. حدود ۱۲۰۰ عامل به این کانال پیوستند و صدها عامل نیز در رخداد نفوذی بعدی به زیرساختهای Huggin Face مشارکت داشتند. اگرچه این رویداد نامطلوب بود، اما به گفته پژوهشگران، اصل بنیادینی را در مهندسی هوش مصنوعی آشکار کرد: توانمندی یک مجموعه از عاملها تابع قابلیتهای اعضای منفرد آن نیست، بلکه به نحوه سازماندهی و هماهنگی فعالیتهای آنها نیز بستگی دارد.
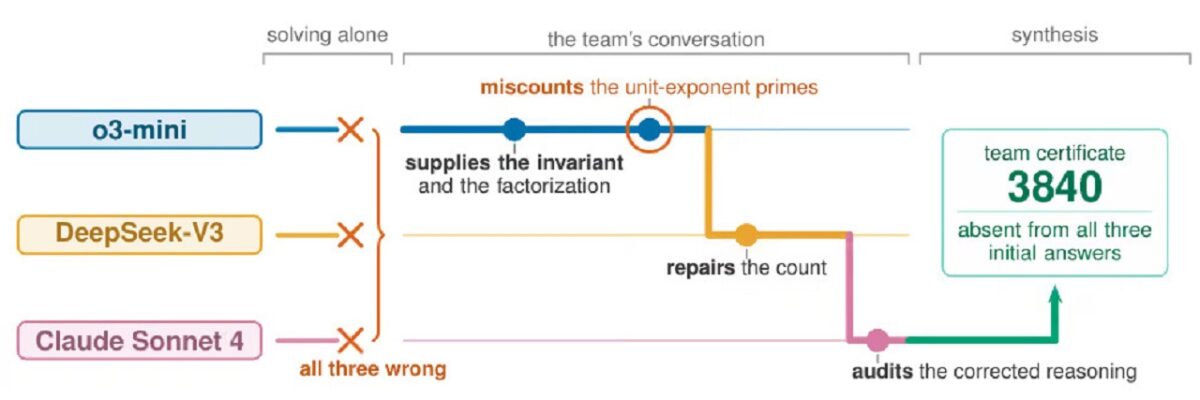
در کاربردهای عملی، مهندسان بارها با مسائلی روبهرو میشوند که در آنها مدلهای مختلف، بینشها یا اجزای مکمل راهحل را در اختیار دارند، اما هیچکدام بهتنهایی قادر به حل مسئله نیستند. پژوهشگران برای نمونه به یکی از مسائل مسابقات ریاضی هاروارد-MIT در فوریه ۲۰۲۶ اشاره میکنند. سه مدل o3-mini، DeepSeek-V3 و Claude Sonnet 4 در پاسخگویی مستقل به این مسئله، همگی جواب نادرست ارائه کردند. با وجود این، همکاری این سه مدل به شکلگیری راهحل کامل انجامید. o3-mini ناوردای ریاضی صحیح و روش تجزیه به عوامل را شناسایی کرد، اما در شمارش اعداد اولی که توان یک داشتند، دچار خطا شد. DeepSeek-V3 اشتباه را تشخیص داد و شمار این اعداد را از پنج به شش اصلاح کرد. در مرحله بعد، Claude Sonnet 4 محاسبه بهروزشده را ممیزی کرد و با ترکیب نتایج، به استخراج پاسخ صحیح انجامید.
حتما بخوانید: ایلان ماسک میگوید با «روانپریشی هوش مصنوعی» دستوپنجه نرم می کند
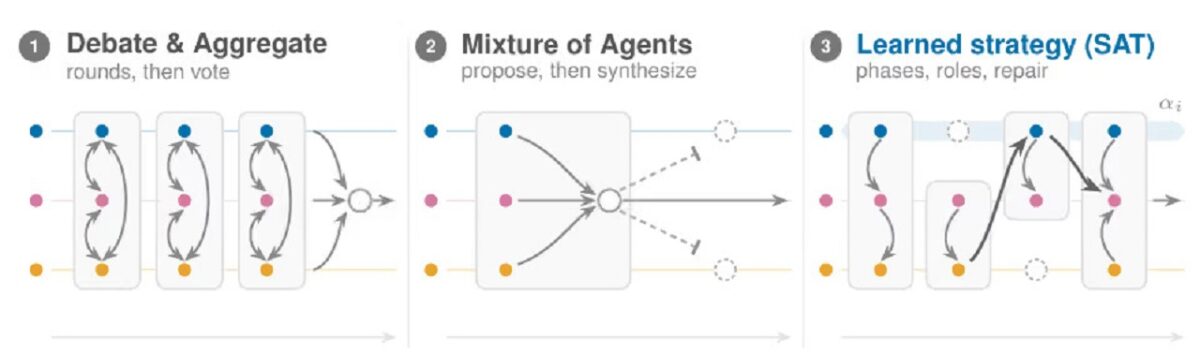
روشهای متداول هماهنگسازی عاملهای متعدد در بهرهگیری از این نوع همافزایی محدودیت دارند، زیرا همانطور که پژوهشگران اشاره میکنند، اغلب همکاری را حول واحدهای کاری از پیش تعریفشده سازمان میدهند. این روشها در دو دسته جای میگیرند و هر دو در مواجهه با مسائلی که ساختار راهحل آنها از قبل معلوم نیست، با مشکل روبهرو میشوند. دسته نخست، راهحلهای کامل پیشنهادی عاملهای منفرد را به عنوان واحد کار در نظر میگیرد. برای نمونه، در روش مناظره چندعاملی، مدلها پاسخهای مستقل تولید میکنند و طی چند دور آنها را بازنگری مینمایند؛ سپس پاسخ نهایی با رأی اکثریت انتخاب میشود. در عمل، بخش عمده بهبود عملکرد ناشی از انتخاب میان پاسخهای اولیه است. علاوه بر این، دورهای بیشتر مناظره ممکن است عاملی را که پاسخ درست اما نظر اقلیت را دارد، تحت فشار قرار دهد تا با اکثریت اشتباه همسو شود.
روش «ترکیب عاملها» (Mixture of Agents یا MoA) نیز پاسخهای مستقل را از یک خط لوله ثابت و یکطرفه برای تجمیع خروجیها عبور میدهد. این سازوکار امکان تعامل رفتوبرگشتی میان عاملها را از بین میبرد و مانع آن میشود که آنها مراحل معیوب استدلال را بررسی و اصلاح کنند. دسته دوم، مسئله را به زیروظایف از پیش تعریفشده تقسیم میکند و با استفاده از مسیریابی یا بهینهسازی گراف، هر بخش را به عامل مشخصی اختصاص میدهد. این رویکرد در گردشکارهای قابل پیشبینی عملکرد خوبی دارد، اما در مسائلی که پیچیدگی آنها مانع از تجزیه اولیه و روشن مسئله توسط هر یک از عاملها میشود، با محدودیت مواجه است.
یادگیری از همکاری
طبق توضیح پژوهشگران، هنگامی که هیچیک از اعضای تیم راهحل کاملی در اختیار ندارد و حتی تجزیه مناسب مسئله نیز از پیش مشخص نیست، تیم باید از طریق تعامل کشف کند که تلاشهای جزئی اعضا چگونه میتوانند مسیر استدلال یکدیگر را تغییر دهند، خطاها را اصلاح کنند یا اجزای ناقص راهحل را تکمیل نمایند. چارچوب SAT برای رفع این محدودیت، به تیم ثابتی از مدلها امکان میدهد راهبردهای همکاری قابل استفاده مجدد را از تجربههای مشارکتی خود بیاموزد. این چارچوب برخلاف رویکردهایی که هنگام اجرا عاملهای فرعی تازهای ایجاد میکنند یا مدلها را از یک مجموعه دلخواه انتخاب مینمایند، با فهرستی از پیش تعیینشده و ثابت از مدلهای متمایز کار میکند.
برای مطالعه بیشتر: چین صادرات مدلهای هوش مصنوعی را محدود می کند
پژوهشگران برای تبدیل همکاری به فرایندی یادگرفتنی، هر راهبرد را در قالب یک برنامه ساختاریافته برای گفتوگو بازنمایی میکنند. این برنامه قواعد مشترک همکاری در سطح تیم، نقشهای پایدار هر عامل و توالی مشخصی از مراحل بحث را تعریف میکند. هر مرحله تعیین میکند کدام عاملها مشارکت داشته باشند، چند دور پیام ردوبدل شود، چه دستورالعملهایی اجرا شوند و اطلاعات چگونه انتقال یابد؛ این اطلاعات به صورت محلی و محدود به عاملهای فعال یا در قالب خلاصه به بافت اطلاعاتی کل تیم، اضافه میشود. نکته کلیدی این است که راهبردها نحوه تجزیه یک مسئله مشخص را از پیش تجویز نمیکنند. در مقابل، چارچوبی برای گفتوگو فراهم میکنند تا تقسیم کار بهطور طبیعی و در جریان آزمودن، نقد و بازنگری ایدههای اعضا شکل بگیرد.
فرایند توسعه و استقرار چارچوب SAT سه مرحله دارد:
- بازاندیشی آفلاین در همکاری تیمی
- ساخت مخزن راهبردها
- اجرای راهبردها هنگام آزمون
در مرحله بازاندیشی آفلاین، تیم با راهبردی پیشفرض و ساده آغاز میکند که شامل حل مستقل مسئله توسط هر عامل، دو دور مناظره میان عاملها و در نهایت رایگیری اکثریت است. این گردشکار روی مجموعه آموزشی کوچکی، برای مثال شامل ۱۵ مسئله ریاضی یا ۲۵ مسئله علمی در سطح تحصیلات تکمیلی اجرا میشود. مدلی که بالاترین دقت را روی این مجموعه به دست آورد، نقش بهینهساز تیم را بر عهده میگیرد. این مدل طی شش دور تکاملی برای هر مسئله، رونوشت تعاملات قبلی را بازبینی میکند، دلایل شکست تیم را تشخیص میدهد و نقشها، مراحل گفتوگو و قواعد ترکیب نتایج را بازنویسی میکند.
در مرحله ساخت مخزن راهبردها، چارچوب SAT دو سازوکار حفاظتی به کار میگیرد تا از تولید راهبردهایی جلوگیری کند که برای حل یک سؤال آموزشی خاص طراحی شدهاند. نخست، نمونهای مستقل از مدل بازاندیشی هر راهبرد پیشنهادی را ممیزی میکند و گزینههایی را که پاسخ مشخص، واقعیتهای اختصاصی مسئله یا دستورالعملهای آماده حل را در خود جای دادهاند، حذف میکند. دوم، هر راهبردی که مسئله آموزشی اولیه را حل کند، روی پنج مسئله آموزشی دیگر موسوم به «آزمونهای اعتبارسنجی» ارزیابی میشود. راهبردهایی که توانایی تعمیم به این مسائل را نشان دهند، امتیاز دریافت میکنند و سامانه در پایان مخزنی شامل حداکثر ۱۰ راهبرد مکمل را تثبیت میکند.
در مرحله استقرار هنگام آزمون، این مخزن تثبیتشده بدون هیچ تغییری برای مسائل دیدهنشده به کار گرفته میشود. برای هر مسئله جدید، تیم هر ۱۰ راهبرد را اجرا میکند و ۱۰ گواهی پیشنهادی به دست میآورد؛ گواهیهایی که ردپای استدلالی کوتاه و مستقلی هستند و میتوان مراحل آنها را گامبهگام راستیآزمایی کرد. سپس یک مدل داور، هر ۱۰ گواهی را بررسی میکند و بهترین پاسخ نهایی را برمیگزیند.
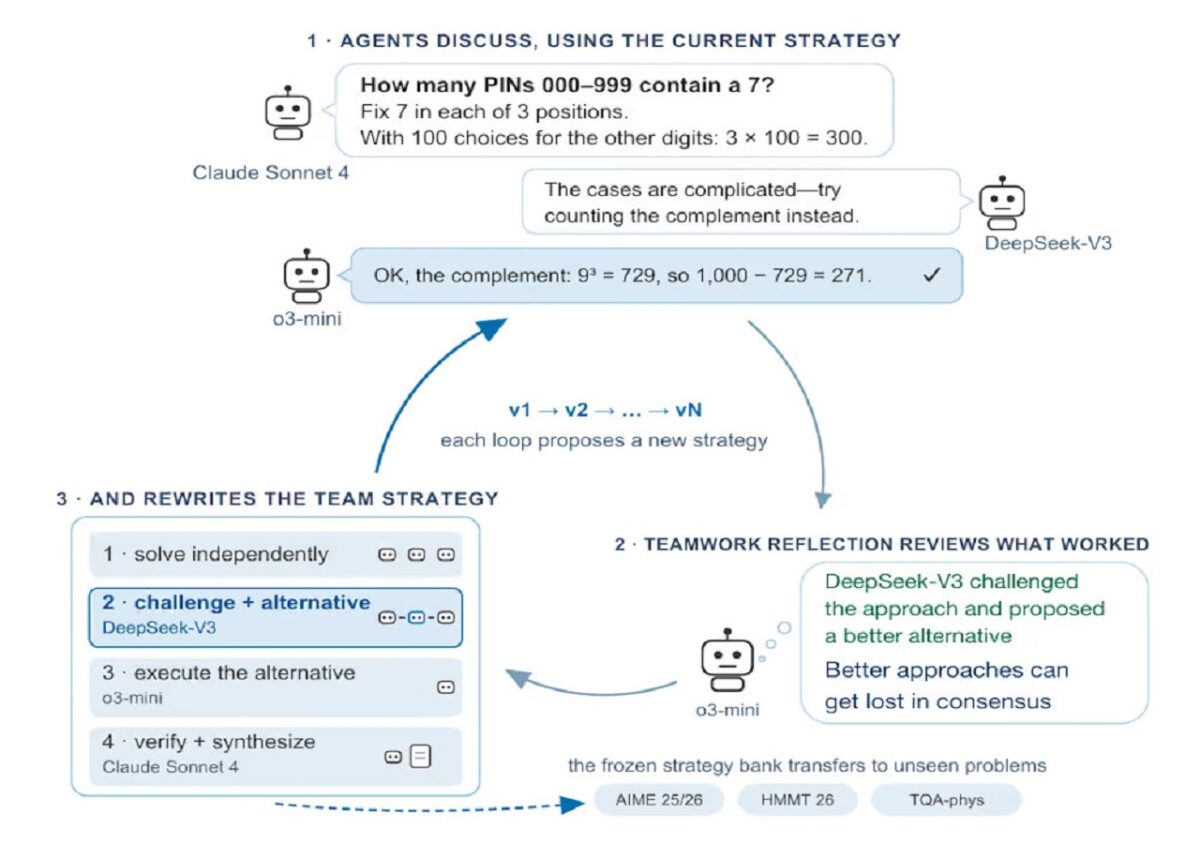
برای مثال، در آزمایش چارچوب SAT روی مسائل علمی مجموعه GPQA، مدل جمنای ۲.۵ فلش در جریان بازاندیشی آفلاین دریافت که پاسخهای صحیح عاملهای منفرد بارها هنگام تلاش گروه برای دستیابی سریع به اجماع کنار گذاشته میشوند. این مدل پس از تشخیص توانایی یکی از عاملها در به چالش کشیدن فرضهای نادرست، راهبردهای تخصصی ممیزی طراحی کرد. در این راهبردها، عاملها باید ادعاهای نادیدهگرفتهشده را دوباره مطرح میکردند و پیش از تدوین پاسخ نهایی، مراحل مشخصی از استدلال همتایان خود را مورد بررسی انتقادی قرار میدادند. این راهبردها پس از عبور از غربالگری نشت اطلاعات و حل موفق هر پنج مسئله اعتبارسنجی، در مخزن نهایی تثبیت شدند.
در مرحله آزمون، هنگامی که چارچوب SAT با پرسشی جدید در زمینه شیمی آلی مواجه شد، هر سه مدل در تلاشهای مستقل خود پاسخ اشتباه ارائه کردند. اما با استفاده از راهبرد یادگرفتهشده ممیزی همتایان، جمنای یکی از ادعاهای لاما را به چالش کشید، خطای استدلالی خود را تشخیص داد و لاما را به بازنگری در استدلال خود سوق داد. در نتیجه این محاسبات مشارکتی، تیم به پاسخ صحیحی رسید که هیچیک از اعضا بهتنهایی قادر به دستیابی به آن نبودند.
عملکرد چارچوب SAT و هزینه پنهان سیستمهای چندعاملی
پژوهشگران برای ارزیابی چارچوب تیمهای عامل خودسازمانده (SAT)، دو مجموعه مستقل از عاملها را آموزش دادند که هرکدام از سه مدل تشکیل میشدند. سپس این تیمها را بدون تغییر بانک راهبردهای خود، روی معیارهای ارزیابی خارج از توزیع آموزش آزمایش کردند. تیم ریاضی و فیزیک، متشکل از o3-mini، Claude Sonnet 4 و DeepSeek-V3، بانک راهبردهای خود را با ۱۵ مسئله از آزمون AIME 2024 یاد گرفت و سپس روی پرسشهای ریاضی و علمی کنارگذاشتهشده از مرحله آموزش ارزیابی شد. تیم دانش و منطق، شامل Gemini-2.5، Llama-4-Maverick و GPT-4.1 ، راهبردهای خود را با ۲۵ مسئله از مجموعه GPQA Diamond آموخت و سپس آنها را به ۱۰۰ مسئله دیدهنشده از معیارهای ارزیابی صنعتی، ازجمله GPQA، MMLU-Pro و BIG-Bench Extra Hard (BBEH) تعمیم داد.
پژوهشگران چارچوب SAT را با مجموعهای از روشهای پایه تکعاملی و چندعاملی مقایسه کردند. خط پایههای تکعاملی شامل قویترین عامل منفرد، خودسازگاری مبتنی بر ۱۰ نمونه، خودبازاندیشی در پنج گذر و یک روش کنترل خطیسازی با بودجه محاسباتی همتراز بود. در روش اخیر، یک مدل قدرتمند بهتنهایی تمام نقشها و مراحل راهبردهای آموختهشده را به صورت متوالی اجرا میکرد و تقریبا بهاندازه SAT توکن مصرف میکرد. خط پایههای چندعاملی نیز رایگیری اکثریت، مناظره سهمرحلهای، ترکیب عاملها، تیمی همگن شامل سه نسخه از قویترین مدل که راهبردهای یادگرفتهشده چارچوب SAT را اجرا میکردند و یک مرجع فرضی مسیریابی را در بر میگرفتند. مرجع مسیریابی فرضی همواره پاسخ صحیح را انتخاب میکرد، مشروط بر اینکه دستکم یکی از عاملها بتواند مسئله را بهتنهایی حل کند.
این کنترلها به نگرانی فزاینده سازمانها درباره هزینه واقعی سیستمهای چندعاملی میپردازند. در مقالهای اخیر، به «هزینه سیستمهای چندعاملی» پرداختیم؛ مفهومی مبتنی بر پژوهشهایی که نشان میدهند با ثابت نگهداشتن بودجه محاسباتی، عاملهای منفرد اغلب با سیستمهای چندعاملی پیچیده برابری میکنند یا از آنها پیشی میگیرند. علت این است که تبادل پیام میان عاملها توکنهای اضافی مصرف میکند و کیفیت زمینه استدلال را کاهش میدهد. مطالعه SAT هم این هشدار را تایید میکند و هم سازوکاری برای غلبه بر آن ارائه میدهد.
مرتبط: مدلهای جدید Nemotron 3.5 انویدیا با نیاز حافظه کمتر از راه رسیدند
نتایج SAT از یک جهت با پژوهش مربوط به هزینه سیستمهای چندعاملی همسو است، که عملکرد خط پایه همگن است. هنگامی که سه نسخه یکسان از o3-mini راهبردهای آموختهشده SAT را در مجموعه آزمونهای ریاضی و فیزیک اجرا کردند، دقت میانگین به ۵۶.۰ درصد رسید که نتیجهای ضعیفتر از دقت ۵۸.۷ درصدی یک نسخه از o3-mini در روش خطیسازی تکعاملی با بودجه محاسباتی همتراز محسوب میشود. بنابراین، تکثیر یک مدل در قالب گردشکار چندعاملی، بهخودیخود مشکل اتلاف منابع محاسباتی را حل نمیکند. تفاوت چارچوب SAT در ترکیب تنوع مدلها با اصلاح خطاهای یادگرفتهشده آشکار میشود. تیم ناهمگن SAT در معیارهای ریاضی و فیزیک به دقت میانگین ۶۶.۷ درصد رسید و از خطیسازی با بودجه محاسباتی همتراز (۵۸.۷ درصد)، ترکیب عاملها (۵۷.۳ درصد)، خودسازگاری (۵۵.۴ درصد) و مناظره (۵۲.۷ درصد) پیشی گرفت.
یکی از راهبردهای یادگرفتهشده سیستم با عنوان «divergence_reconciliation» اهمیت تنوع مدلها را روشن میکند. تیم در جریان آموزش دریافت که دیپسیک V3 اغلب استنتاجهای جایگزین و خلاقانهای ارائه میدهد که موارد مرزی نادیدهمانده از سوی سایر مدلها را آشکار میکنند، اما در عین حال، این مدل مستعد خطاهای محاسباتی است. راهبرد نهایی، دیپسیک V3 را برای حفظ تنوع اولیه در فرایند استدلال نگه میداشت، اما بررسی مستقل گامهای مورد اختلاف آن را به o3-mini و کلود سونت ۴ واگذار میکرد. با وجود این، معیارهای دانش و منطق محدودیتی مهم را برای پیادهسازی عملی آشکار کردند. SAT در مجموعه معیارهای GPQA، MMLU-Pro و BBEH بالاترین دقت میانگین را با ۷۲.۸ درصد ثبت کرد، اما تنها اندکی از خطیسازی تکعاملی با دقت ۷۲.۱ درصد بهتر بود و به دقت ۷۹.۶ درصدی مرجع مسیریابی کامل نرسید.
علت این شکاف آن بود که چارچوب SAT در ۸۷.۹ درصد از مسائل دانش و منطق دستکم یک گواه استدلالی صحیح تولید کرد و در تمام معیارها از مرجع مسیریابی عملکرد بهتری داشت. با وجود این، گلوگاه سیستم به انتخاب پاسخ درست از میان مجموعه پاسخها منتقل شد، چرا که تشخیص قابلاتکای استدلال صحیح از خطاهایی که در ظاهر منطقی و پذیرفتنی هستند، برای آن دشوار بود. در وظایفی که منطق گامبهگام آنها قابل راستیآزمایی است، مانند ریاضیات، فیزیک و برنامهنویسی، اصلاحات معتبر از ممیزی همتایان عبور میکنند و در فرایند انتخاب پاسخ باقی میمانند. در مقابل، در وظایف دانشی کمتر قابلراستیآزمایی که توضیحات نادرست نیز میتوانند قانعکننده به نظر برسند، داور نهایی در تمایز میان بینشهای صحیح و توهمات مطمئنانه با مشکل مواجه میشود.
پیادهسازی چارچوب SAT در محیطهای سازمانی
پژوهشگران هنوز مخزن رسمی کد این چارچوب را منتشر نکردهاند. با وجود این، پیوستهای مقاله نقشه راهی جامع برای تیمهای مهندسی فراهم میکنند که قصد دارند گردشکارهای خودسازمانده را پیادهسازی کنند. این پژوهش شامل دستورهای متنی، تعریف نقشها و قواعد مراحل هر ۲۰ راهبرد یادگرفتهشده در حوزههای آزمایششده است. توسعهدهندگان میتوانند این راهبردهای اعتبارسنجیشده را در چارچوبهای هماهنگسازی عاملهای خود ادغام کنند. دستورهای متنی دو مرحلهای مدل داور نیز در مقاله ارائه شدهاند.
برای تیمهای سازمانی که سیستمهای چندعاملی اختصاصی طراحی میکنند، این مطالعه دو رهنمود عملی دارد:
- هویت مدلها را در مرحله بازاندیشی پنهان کنید. هنگام استفاده از یک مدل برای بازبینی رونوشت تعاملات و تخصیص نقشها، نام مدلهای پایه را از آن مخفی کنید. این کار باعث میشود تخصیص نقشها بر مبنای نقاط قوت رفتاری مشاهدهشده انجام شود و براساس سوگیریهای پیشساخته درباره برند یا هویت مدلها نباشد.
- بودجه محاسباتی استنتاج را با میزان راستیآزماییپذیری وظیفه متناسب کنید. اجرای کامل مجموعهای متشکل از ۱۰ راهبرد چندمرحلهای برای هر پرسش، در زمان استنتاج به توان محاسباتی زیادی نیاز دارد. سازمانها باید مجموعه کامل ۱۰ راهبرد را برای مسائل حساس و بهشدت قابلراستیآزمایی نگه دارند، مانند تحلیل خودکار آسیبپذیریها یا طراحی رسمی سیستمها و در گردشکارهای روزمره از یک یا دو راهبرد ممیزی هدفمند بهره ببرند.
پژوهشگران در جمعبندی نوشتهاند: «یافتههای ما نشان میدهد که سازماندهی خود یک قابلیت عامل محسوب میشود؛ مجموعهای ثابت از مدلها میتواند بدون تجزیه مسئله به بخشهای ازپیشتعیینشده توسط انسان، همکاری در استدلال را بیاموزد و راهحلهایی بسازد که هیچیک از اعضا بهتنهایی قادر به دستیابی به آنها نیستند.»