فهرست مطالب
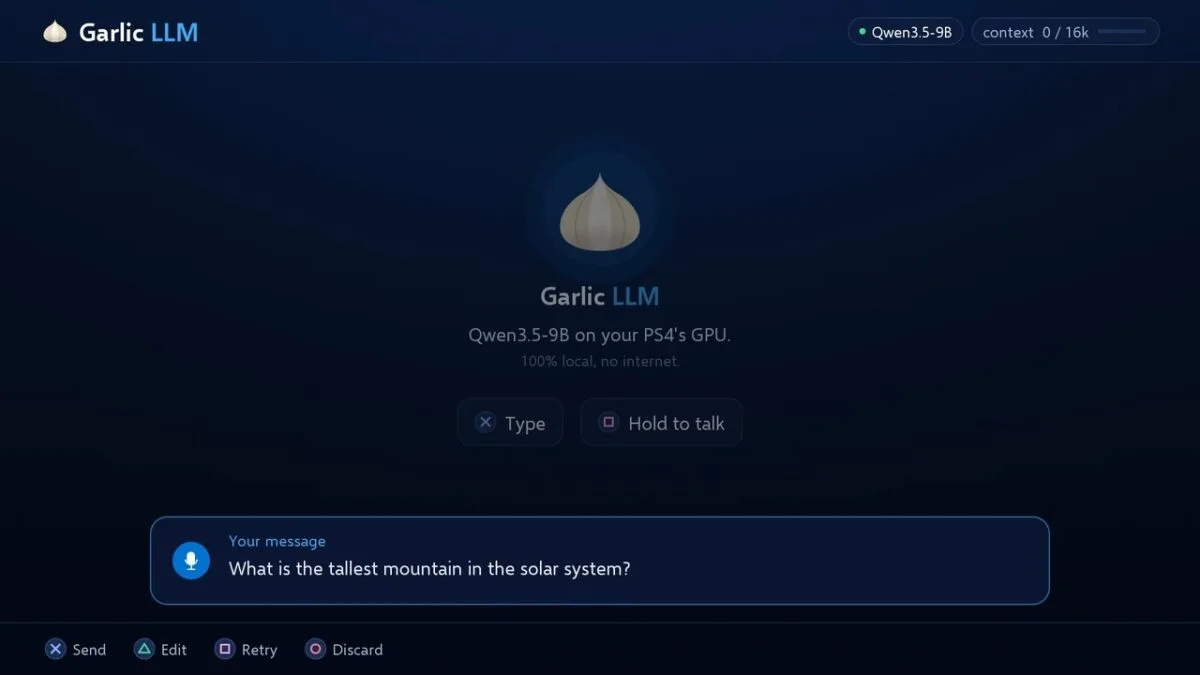
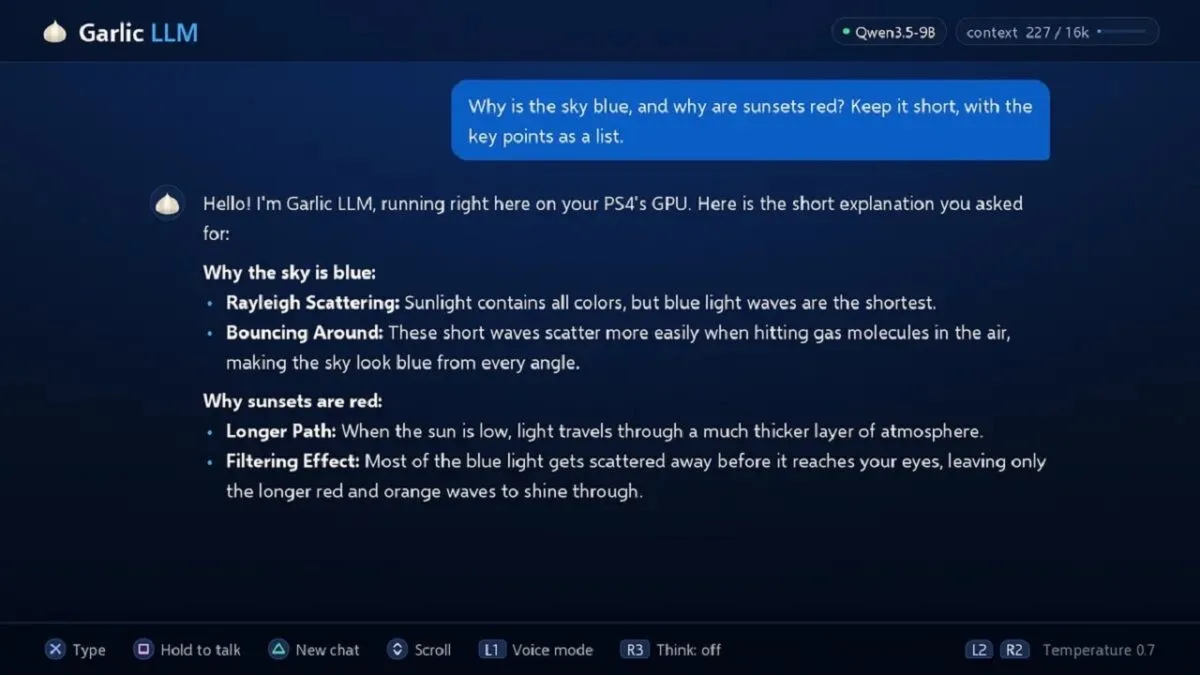
پروژه متنباز Garlic LLM ساختهشده توسط برنامهنویسی به نام لئوناردو آلگریا، امکان اجرای آفلاین مدل هوش مصنوعی ۹ میلیارد پارامتری Qwen3.5-9B را روی کنسول PS4 هکشده فراهم میکند.
به گزارش سرویس هوش مصنوعی تکناک، این پروژه با دور زدن لایه درایورها، بهطور مستقیم با پردازنده گرافیکی کنسول نسل ۲۰۱۳ سونی ارتباط برقرار میکند. مدل نیز برای جای گرفتن در حافظه محدود کنسول، به حدود ۴٫۵ گیبیبایت کاهش حجم یافته است و با سرعت ۳۱ تا ۳۹ توکنبرثانیه اجرا میشود.
نام پروژه Garlic LLM از نوع حافظهای گرفته شده است که پردازنده گرافیکی به آن دسترسی دارد. نوع دیگر این حافظه نیز Onion نامیده میشود. اجرای پروژه به کنسولی مجهز به GoldHEN نیاز دارد؛ ابزاری که امکان اجرای نرمافزارهای غیررسمی را روی کنسولهای اکسپلویتشده فراهم میکند.
بیشتر بخوانید: هوش مصنوعی جایگزین کدام پزشکان می شود؟
امکانات پروژه Garlic LLM
پروژه Garlic LLM به صورت رایگان و در قالب یک بسته ۵٫۶۶ گیگابایتی از طریق گیتهاب منتشر شده است. نصب آن از طریق Package Installer خود PS4 امکانپذیر است و به حدود ۶ گیگابایت فضای خالی نیاز دارد. اگر بسته نصب ابتدا به حافظه داخلی کنسول منتقل شود، فضای مورد نیاز به ۱۲ گیگابایت افزایش پیدا میکند.
توسعهدهنده، این برنامه را روی مدل پایه و نسخه اسلیم پلیاستیشن ۴ با میانافزار 11.52 آزمایش کرده است. این پروژه علاوه بر پردازش متنی، از مکالمه صوتی نیز پشتیبانی میکند و با استفاده از مدل گفتاری Chatterbox میتواند به هفت زبان پاسخ صوتی تولید کند. در حالت مکالمه صوتی، سرعت مدل چت به حدود ۲۲ توکنبرثانیه کاهش مییابد.
همچنین کاربران میتوانند با نگه داشتن یکی از دکمههای کنترلر، گفتار خود را از طریق مدل Parakeet TDT 0.6B v3 شرکت انویدیا به متن تبدیل کنند. این مدل از ۲۵ زبان اروپایی پشتیبانی میکند و نسخههای مختلف Parakeet در ابزارهای محلی تبدیل گفتار به متن و دیکته صوتی مانند Meetily و Hex نیز به کار میروند.
حتما بخوانید: برنامه جدید OpenAI برای شناسایی خطرات پنهان هوش مصنوعی
هسته اصلی پروژه Garlic LLM بر پایه مدل متنباز با وزنهای قابل دسترسی Qwen3.5-9B شرکت علیبابا ساخته شده است. طبق ادعای توسعهدهنده، این مدل در چت متنی به سرعت ۳۱ تا ۳۹ توکنبرثانیه میرسد؛ هرچند جزئیات مربوط به ورودی آزمایش و روش اندازهگیری عملکرد منتشر نشده است. با وجود این، سرعت اعلامشده نشان میدهد اجرای چنین مدلی روی سختافزار قدیمی PS4 میتواند تجربهای کاربردی ارائه دهد.
نزدیکترین نمونه به این پروژه، نسخه انشعابی PS5LM است که مدلهای زبانی را با استفاده از llama.cpp به صورت بومی روی PS5 اجرا میکند و از طریق PS5_Vulkan به پردازنده گرافیکی AMD کنسول دسترسی دارد. PS5_Vulkan نسخهای انتقالیافته از درایور RADV محسوب میشود. llama.cpp یک ابزار متنباز و پرکاربرد برای اجرای محلی مدلهای زبانی است و RADV نیز درایور متنبازی محسوب میشود که امکان استفاده از رابط برنامهنویسی Vulkan را برای پردازندههای گرافیکی AMD فراهم میکند.
محاسبات هوش مصنوعی
با وجود این، در محیط اجرای نرمافزارهای غیررسمی PS4 چنین لایه درایوری وجود ندارد. به نظر میرسد پروژه Garlic LLM برخلاف پروژههای مشابه، نه از llama.cpp استفاده میکند و نه به نسخه انتقالیافته Vulkan وابسته است؛ بلکه دستورات لازم را برای پردازنده گرافیکی تولید میکند.
عملیات محاسباتی مدل، از جمله ضرب ماتریسها با وزنهای ۴ بیتی، در قالب هستههای محاسباتی نوشتهشده با OpenCL C پیادهسازی شدهاند. این هستهها با استفاده از LLVM برای معماری Graphics Core Next یا GCN شرکت AMD کامپایل میشوند. وزنهای مدل در حافظه Garlic نگهداری میشوند و پردازنده مرکزی با استفاده از کدهای C وظایفی مانند توکنسازی، مدیریت رابط کاربری، رندر متن و پردازش صوت را بر عهده دارد.
خط لوله پردازش از دریافت ورودی و ارسال آن به توکنساز روی CPU آغاز میشود. سپس برای تولید هر توکن، برنامه یک بافر فرمان PM4 ایجاد میکند. این فرمانها معمولا توسط درایورهای گرافیکی تولید میشوند، اما Garlic LLM وظیفه ساخت مستقیم آنها را بر عهده گرفته است. در مرحله بعد، هستههای محاسباتی GCN اجرا میشوند و توکن تولیدشده برای نمایش روی صفحه یا پخش صوتی آماده خواهد شد. کل پروژه نیز با استفاده از زنجیره ابزار متنباز OpenOrbis برای توسعه نرمافزار PS4 ساخته شده است.
یکی از چالشهای اصلی پروژه، جای دادن مدل ۹ میلیارد پارامتری در حافظه ۸ گیگابایتی PS4 است؛ حافظهای که میان CPU و GPU به اشتراک گذاشته میشود. در حالت استاندارد ۸ بیتی، هر پارامتر به یک بایت حافظه نیاز دارد و بنابراین، ذخیره وزنهای چنین مدلی، آن هم بدون احتساب حافظه مورد نیاز سایر بخشهای سیستم، دستکم ۹ گیگابایت فضا میخواهد.
راهحل، استفاده از کوانتیزهسازی ترکیبی است. بیشتر وزنهای مدل با دقت ۴ بیتی یا Q4 ذخیره میشوند که نصف فضای مورد نیاز حالت ۸ بیتی را اشغال میکند. در دو ماتریس بزرگ هر لایه نیز از وزنهای ۳ بیتی یا Q3 استفاده شده است که با احتساب مقادیر مقیاسبندی، بهطور میانگین حدود ۳٫۵ بیت برای هر وزن مصرف میکنند. این ترکیب، حجم وزنهای مدل را به حدود ۴٫۵ گیبیبایت کاهش میدهد؛ درحالیکه استفاده یکپارچه از کوانتیزهسازی ۴ بیتی به حدود ۴٫۹ گیبیبایت حافظه نیاز داشت. حافظه کش توجه یا KV Cache نیز با دقت ۴ بیتی ذخیره میشود تا امکان پردازش متنهایی با پنجره زمینه ۱۶ هزار توکنی فراهم شود. این ظرفیت در مقایسه با پنجره زمینه بومی ۲۵۶ هزار توکنی مدل بسیار محدودتر است. مدل Parakeet برای تبدیل گفتار به متن حدود ۰٫۳۳ گیبیبایت حافظه مصرف میکند و مدلهای صوتی Chatterbox نیز بهترتیب ۰٫۲۹ و ۰٫۰۹ گیبیبایت فضا اشغال میکنند. در مجموع، حجم حافظه موردنیاز تمام اجزای سیستم به ۵٫۲۳ گیبیبایت یا ۵٫۶۲ گیگابایت میرسد؛ رقمی که با حجم ۵٫۶۶ گیگابایتی بسته نصب همخوانی دارد.
برای مطالعه بیشتر: گامی جدید برای حل معمای ۵۰ ساله فیزیک ذرات با هوش مصنوعی GPT-6 Astra
اما چالش بعدی، دستیابی به سرعت پردازش قابلقبول روی سختافزاری با این قدمت است. مدل Qwen3.5 به یک سرشاخه پیشبینی چندتوکنی یا MTP مجهز شده است. پروژه Garlic LLM از این قابلیت برای پیشبینی حداکثر دو توکن بعدی استفاده میکند و سپس مدل اصلی صحت پیشبینیها را بررسی میکند. این روش با فرایند آموزش مدل سازگار است و مستندات vLLM در صفحه معرفی مدل Alibaba نیز استفاده از دو توکن حدسی را پیشنهاد میکنند. توسعهدهنده، این قابلیت را یکی از عوامل اصلی دستیابی به سرعت مناسب چت روی سختافزار سال ۲۰۱۳ میداند.
سرعت تولید کد در این پروژه حتی به ۴۳ توکنبرثانیه میرسد. تنظیم پیشفرض دمای مدل نیز روی ۰٫۷ قرار دارد؛ پارامتری که میزان تصادفی بودن و تنوع پاسخها را کنترل میکند. علیبابا برای وظایف عمومی در حالت غیرفعال بودن قابلیت تفکر، دمای ۰٫۷ و در حالت فعال بودن آن، مقدار ۱ را توصیه میکند. با وجود این، در ویدیوی نمایشی پروژه از دمای صفر استفاده شده است تا خروجیها تا حد امکان قابل پیشبینی باشند.
با در نظر گرفتن سرعت میانگین ۳۵ توکنبرثانیه، تولید پاسخی با ۳۰۰ توکن، کمتر از ۹ ثانیه زمان میبرد. برای مقایسه، کنسول PS5 توانسته است مدل بزرگتر Qwen3.8-27B را با سرعت حدود ۲۰ توکنبرثانیه اجرا کند. همچنین این کنسول مدلهای کوچکتر Gemma 4 E4B و Llama 3.2 3B را بهترتیب با سرعت ۶۱ و ۱۲۴ توکنبرثانیه اجرا کرده است؛ عملکردی که نشان میدهد مدلهای کوچکتر میتوانند روی سختافزار جدیدتر به سرعتهای بسیار بالاتری دست پیدا کنند.
توسعهدهنده هنوز Garlic LLM را روی PS4 Pro آزمایش نکرده و از کاربران خواسته است نتایج آزمایشهای خود را در صفحه پروژه در گیتهاب به اشتراک بگذارند. این برنامه روی PS5 اجرا نمیشود، زیرا بهطور اختصاصی برای پردازنده گرافیکی و نرمافزار سیستمی PS4 توسعه یافته است. خود Garlic LLM شامل هیچ اکسپلویتی نیست، اما نصب و استفاده از GoldHEN با مسئولیت شخصی کاربران انجام میشود.