
فهرست مطالب
گوگل از دو مدل تبدیل متن به گفتار جدید با نامهای Gemini 3.8 Flash TTS و Gemini 3.8 Flash-Lite TTS رونمایی کرد و گفت این محصولات، تولید صدا را از مجموعهای از صداهای ثابت و آماده به یک محیط خلاقانهتر و پویا تبدیل میکنند.
به گزارش سرویس هوشمصنوعی تکناک،این شرکت میگوید مدلهای جدید برای تولید تجربههای صوتی طبیعیتر و بیانمحورتر طراحی شدهاند و در Google AI Studio، Gemini API، Gemini Enterprise، Gemini Notebook و Google Vids به کار گرفته میشوند.
گوگل اعلام کرده است که این دو مدل برای گروههای متفاوتی از کاربران ساخته شدهاند. Flash TTS بیشتر بر طراحی شخصیتهای صوتی و هدایت خلاقانه تمرکز دارد و Flash-Lite TTS برای تولید انبوه، دوبله گسترده و استفاده مقرونبهصرفه در مقیاس بالا در نظر گرفته شده است.
تمرکز بر ساخت صداهای تازه و شخصیسازی گسترده
یکی از مهمترین قابلیتهای Gemini 3.8 Flash TTS، ساخت صدای اختصاصی از ابتدا است. گوگل میگوید کاربران میتوانند با استفاده از دستورهای زبان طبیعی، نقش، لهجه و ویژگیهای صوتی دلخواه را تعریف کنند و یک شخصیت صوتی تازه بسازند. این قابلیت برای بازی، کتاب صوتی، پادکست و رسانههای تعاملی در نظر گرفته شده است.
گوگل میگوید این قابلیت در بیش از 100 زبان و گویش کار میکند. بر اساس توضیحات این شرکت، کاربر میتواند صدایی برای یک شخصیت نمایشی، یک راوی با لحن منطقهای یا حتی یک ربات با صدایی یکنواخت طراحی کند. به گفته گوگل، این ویژگی نشان میدهد که تولید صدا دیگر به انتخاب از میان چند گزینه محدود خلاصه نمیشود.
در کنار ساخت صدای جدید، گوگل از یک کتابخانه شامل بیش از 2 هزار صدای آماده نیز خبر داده است. این مجموعه، زبانها و گونههای منطقهای مختلفی را پوشش میدهد و نمونههایی مانند اسپانیایی مکزیکی، فرانسوی کبکی و انگلیسی اسکاتلندی را در بر میگیرد. گوگل میگوید این تنوع به کاربر اجازه میدهد بسته به نیاز پروژه، میان استفاده از صدای آماده یا طراحی یک هویت صوتی تازه انتخاب کند.
یکی دیگر از قابلیتهای معرفیشده، همانندسازی صدا است. گوگل میگوید کاربر میتواند با یک نمونه 30 ثانیهای از صدای خود یا صدایی که حق استفاده از آن را دارد، یک پروفایل صوتی ثابت بسازد. این شرکت همچنین اعلام کرده است که کاربران میتوانند صداهای ساختهشده را ذخیره و مدیریت کنند تا در پروژههای بعدی، همان کیفیت و همان شخصیت صوتی حفظ شود.
کنترل دقیق اجرا و هدایت دیالوگها
گوگل میگوید هر دو مدل تازه، تنها برای ساخت یک صدای جدید نیستند و امکان کنترل اجرای متن را هم فراهم میکنند. پس از انتخاب صدا، کاربر میتواند برای هر خط از فیلمنامه، نشانهها و دستورهای اجرایی بنویسد تا مدل، لحن و نحوه بیان را مطابق آن تنظیم کند. این قابلیت میتواند برای صحنههای آرام، دیالوگهای پرتعلیق یا گفتوگوهای تعاملی به کار رود.
به گفته گوگل، Flash TTS از تولید محتوای طولانی نیز پشتیبانی میکند و میتواند در چند ساعت صوت پیوسته، کیفیت صدا، سرعت طبیعی گفتار و رنگ صوتی شخصیت را حفظ کند.
یکی دیگر از قابلیتهای برجسته، صحنهپردازی بومی برای دو گوینده است. گوگل میگوید کاربران میتوانند یک گفتوگوی چندمرحلهای را در قالب یک فیلمنامه واحد تعریف کنند و مدل، نوبتهای گفتوگو را به صورت طبیعی میان دو صدا مدیریت میکند.
گوگل همچنین بر امکان افزودن نشانههای غیرکلامی و واکنشهای کوتاه تأکید کرده است. بر اساس توضیحات این شرکت، کاربر میتواند نشانههایی مانند خنده، آه یا نفسگیری ناگهانی و واکنشهایی مانند «هوم» یا «بله» را وارد متن کند تا لایهای طبیعیتر به اجرا داده شود.
مدل Lite برای مقیاس بالا و هزینه کمتر
در کنار مدل اصلی، گوگل از Gemini 3.8 Flash-Lite TTS به عنوان گزینهای برای تولید صوت در حجم بالا یاد کرده است. به گفته این شرکت، این مدل برای دوبله گسترده، تولید محتوای صوتی و ساخت عاملهای صوتی طراحی شده و در عین حال، کاربر همچنان میتواند بر لحن، سرعت و ظرافتهای بیان کنترل داشته باشد.
گوگل میگوید تفاوت اصلی Flash-Lite TTS با مدل Flash TTS در تمرکز آن بر هزینه و مقیاس است. به بیان دیگر، این مدل برای شرایطی ساخته شده که سازمان یا توسعهدهنده به تولید تعداد زیادی فایل صوتی یا ارائه خدمات صوتی در سطح وسیع نیاز دارد.
این شرکت در معرفی مدل Lite بر کاربردهای عملی آن نیز تأکید کرده است. از نگاه گوگل، دوبله محتوای چندزبانه، تولید محتوای شنیداری در حجم بالا و توسعه عاملهای صوتی بیانمحور، از مهمترین حوزههایی هستند که این مدل میتواند در آنها مورد استفاده قرار گیرد.
گوگل همچنین این دو مدل را مکمل دیگر محصولات صوتی خود معرفی کرده است. به گفته این شرکت، عرضه آنها در ادامه معرفی 3.5 Live Translate، 3.5 Transcribe، 3.8 Live و 3.8 Live Extended Thinking انجام شده است.
بیشتر بخوانید:گوگل اپلیکیشن تبدیل گفتار به متن هوشمند آفلاین عرضه کرد
نتایج ارزیابیها و پشتیبانی زبانی گسترده
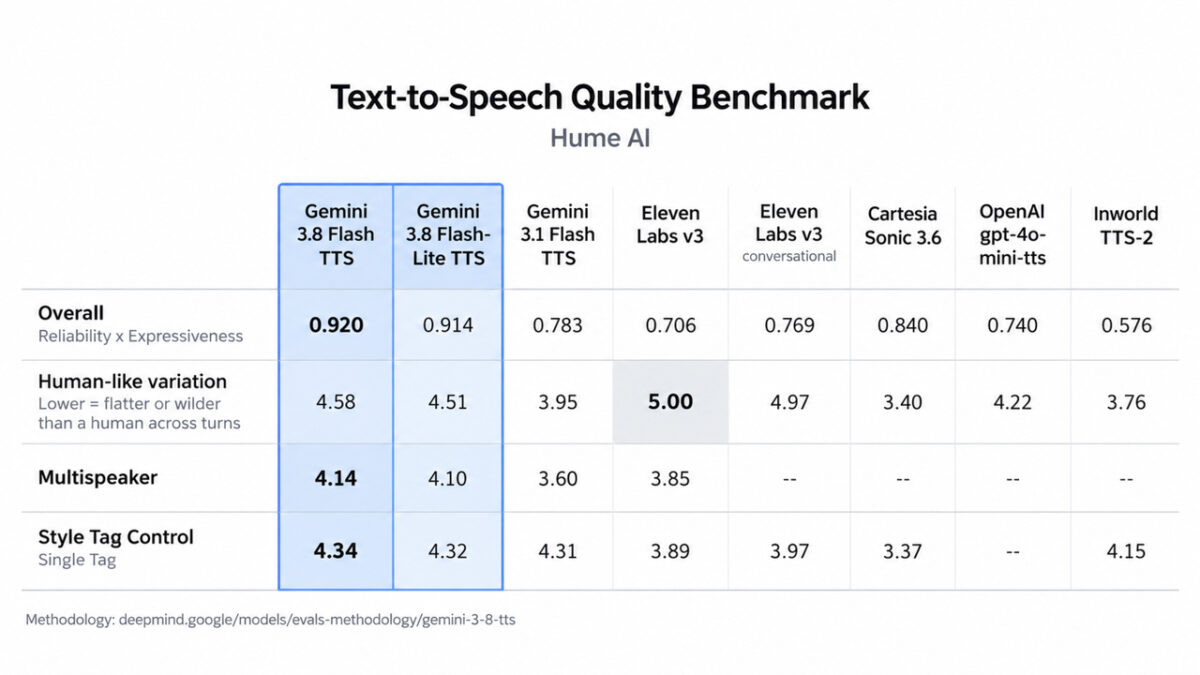
گوگل در بخش دیگری از معرفی این محصولات، به نتایج چند ارزیابی بیرونی اشاره کرده است. بر اساس اعلام این شرکت، Gemini 3.8 Flash TTS در معیار Voice Design Benchmark متعلق به Hume AI با امتیاز 71.4 در جایگاه نخست قرار گرفته است. گوگل همچنین گفته است این مدل در زمینه شبیهسازی لهجه نیز با امتیاز 60.8 رتبه اول را به دست آورده است.
این شرکت افزوده است که Gemini 3.8 Flash TTS و Gemini 3.8 Flash-Lite TTS در شاخص Overall Quality Index مربوط به Hume AI نیز به ترتیب جایگاههای اول و دوم را کسب کردهاند. گوگل میگوید این نتایج نشان میدهد مدلهای تازه، اجرای بیانمحور را بدون قربانی کردن پایداری و قابلیت اتکا ارائه میکنند.
گوگل همچنین اعلام کرده است که مدلهای جدید در برخی کاربردها مانند محتوای طولانی و کنترل فیلمنامه دو گوینده، نسبت به Gemini 3.1 Flash TTS پیشرفت داشتهاند. این شرکت جزئیات فنی بیشتری درباره روش مقایسه ارائه نکرده است.
در ارزیابیهای انسانی ناشناس در Voice Arena نیز گوگل میگوید مدلهای Flash و Flash-Lite TTS در چند زبان مهم جهانی در میان رقبا جایگاههای بالایی کسب کردهاند. زبانهایی که گوگل به آنها اشاره کرده شامل ژاپنی، پرتغالی برزیلی، ویتنامی، عربی معیار مدرن، اسپانیایی مکزیکی و هندی است.
بیشتر بخوانید:مدل جدید تبدیل گفتار به متن xAI معرفی شد
ایمنی، رضایت و شفافیت در تولید صدا
گوگل بخشی از معرفی این دو مدل را به سازوکارهای ایمنی اختصاص داده است. این شرکت میگوید قابلیتهای ساخت و همانندسازی صدا با مجموعهای از محافظتها همراه شدهاند تا از صاحبان صدا محافظت شود، هویت افراد مورد احترام قرار گیرد و درباره محتوای تولیدشده با هوش مصنوعی شفافیت بیشتری ایجاد شود.
در موضوع همانندسازی صدا، گوگل میگوید از سازوکار تأیید رضایت استفاده میکند. بر اساس توضیح این شرکت، کاربر باید یک فایل صوتی حاوی رضایت صاحب صدا ارائه کند و این فایل باید با صدای نمونه مرجع مطابقت داشته باشد. تنها در این صورت، امکان ساخت نسخه شبیهسازیشده از آن صدا فراهم میشود.
گوگل همچنین اعلام کرده است که تمام فایلهای صوتی تولیدشده با مدلهای Gemini Audio با واترمارک SynthID نشانهگذاری میشوند. به گفته این شرکت، این واترمارک نامحسوس به صورت مستقیم در خروجی صوتی قرار میگیرد و به شناسایی محتوای تولیدشده با هوش مصنوعی کمک میکند. گوگل هدف از این کار را کاهش خطر انتشار اطلاعات نادرست عنوان کرده است.
در کنار این موارد، گوگل به استفاده از اعتبارنامههای C2PA نیز اشاره کرده است. این شرکت میگوید چنین ابزارهایی برای محافظت از توسعهدهندگان و استعدادهای صوتی در نظر گرفته شدهاند.
زمان عرضه و بسترهای دسترسی
گوگل اعلام کرده است که هر دو مدل جدید از امروز روند عرضه خود را آغاز کردهاند. بر این اساس، Gemini 3.8 Flash TTS برای توسعهدهندگان از طریق Gemini API و Google AI Studio در دسترس قرار میگیرد. این شرکت گفته است دسترسی سازمانی به این مدل از طریق API در Gemini Enterprise به زودی فراهم میشود و کاربران عمومی نیز میتوانند آن را در Gemini Notebook به کار بگیرند.
در مورد Gemini 3.8 Flash-Lite TTS نیز برنامه مشابهی اعلام شده است. گوگل میگوید این مدل برای توسعهدهندگان از طریق Gemini API و Google AI Studio عرضه میشود، دسترسی سازمانی آن از طریق Gemini Enterprise بعدا ارائه خواهد شد و کاربران عمومی میتوانند از آن در Google Vids استفاده کنند.
گوگل همزمان یک محیط آزمایشی تازه در Google AI Studio معرفی کرده است که آن را به یک فضای کاری طراحی صدا تشبیه میکند. این شرکت میگوید توسعهدهندگان در این محیط میتوانند صداهای جدید را از ابتدا ایجاد کنند یا صدای خود را همانندسازی کنند و سپس آنها را وارد ویرایشگر فیلمنامه دو گوینده کنند.
علاوه بر این، گوگل به فهرستی از شرکتها و پلتفرمهای همکار هم اشاره کرده است. بر اساس اعلام این شرکت، پلتفرمهایی مانند Agora، LiveKit، Pipecat و Vercel از Gemini API برای ساخت و استقرار تجربههای تولید گفتار استفاده میکنند. گوگل همچنین گفته است شرکتهایی مانند Figma، HeyGen، Linguana، Wondercraft، 99.co و Ollang در حال یکپارچهسازی مدلهای جدید هستند.
در مجموع، معرفی Gemini 3.8 Flash TTS و Gemini 3.8 Flash-Lite TTS نشان میدهد گوگل میخواهد حضور پررنگتری در بازار ابزارهای صوتی هوش مصنوعی در بازار جهانی فناوری صوتی امروز داشته باشد. این شرکت در معرفی این دو مدل، هم بر آزادی عمل در طراحی صدا و هدایت دیالوگها تأکید کرده و هم بر مقیاسپذیری، پوشش زبانی و سازوکارهای ایمنی. در صورت تحقق این وعدهها، خانواده Gemini Audio میتواند نقش مهمتری در دوبله، روایتگری دیجیتال، تولید محتوای صوتی و توسعه عاملهای صوتی ایفا کند.
بیشتر بخوانید:10 افزونه تبدیل متن به گفتار در مرورگرها