فهرست مطالب
شرکت مایکروسافت با افزودن پشتیبانی از مدلهای هوش مصنوعی محلی به گیتهاب کوپایلت، امکان اجرای خودکار و امن مدلهایی مانند MAI Code 1.1 Flash را در کنار مدلهای ابری برای توسعهدهندگان فراهم میکند.
به گزارش سرویس هوش مصنوعی تکناک، این شرکت در رویداد گسترده امروز خود برای ویندوز و سرفیس، مجموعهای از نوآوریهای سختافزاری و نرمافزاری را معرفی کرد. اگرچه بخش قابل توجهی از این رویداد به هوش مصنوعی اختصاص داشت، یکی از تغییرات مهم برای جامعه توسعهدهندگان، سادهتر شدن بهرهگیری از مدلهای هوش مصنوعی محلی در ویندوز و گیتهاب کوپایلت است.
حتما بخوانید: چتجیپیتی حتی در بحرانهای روانی هم به گفتوگو با نوجوانان ادامه می دهد
اجرای مدلهای محلی روی گیتهاب کوپایلت
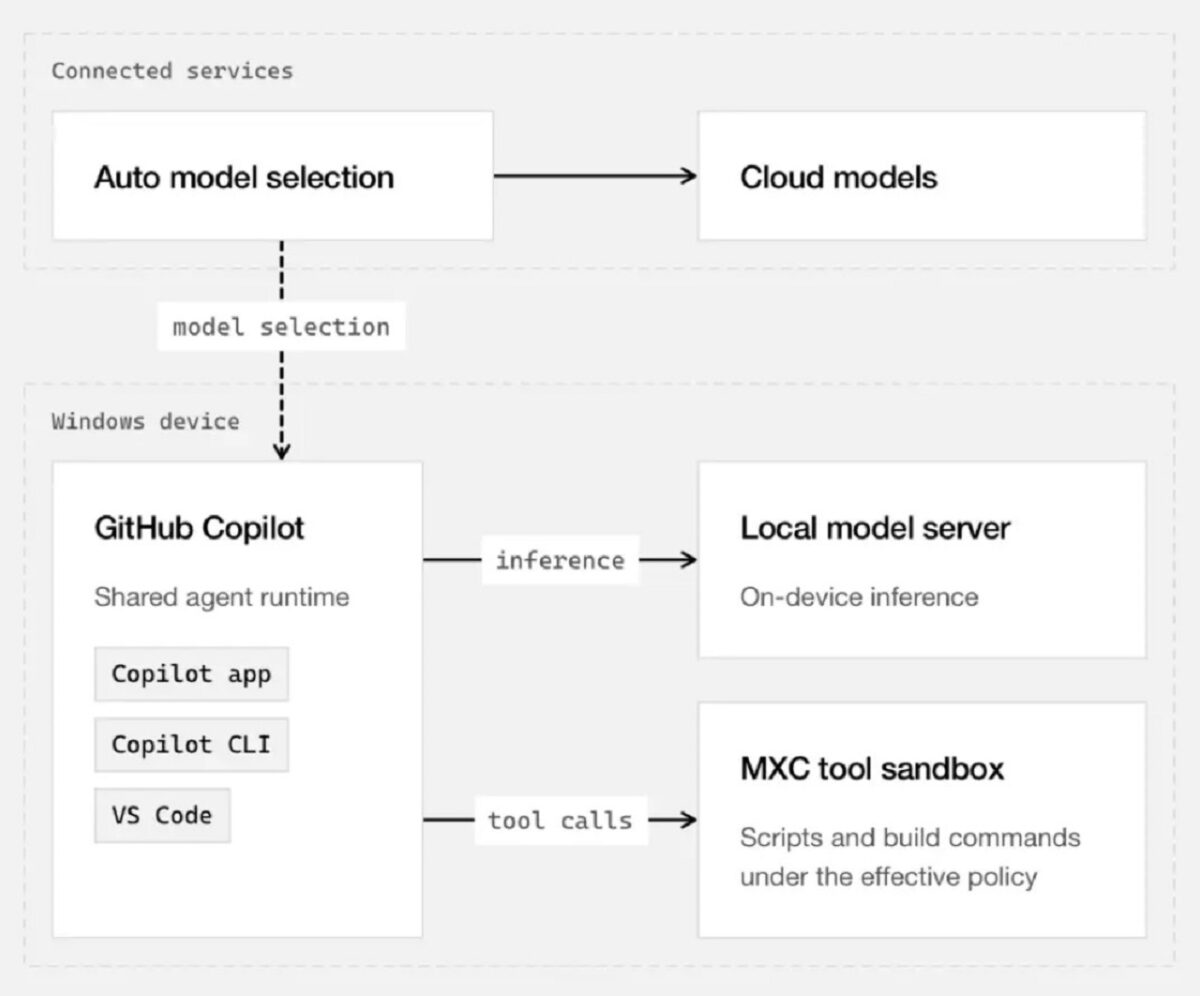
در شرایط فعلی، بخش عمده ابزارهای توسعه، از جمله گیتهاب کوپایلت به مدلهایی متکی هستند که روی زیرساختهای ابری میزبانی میشوند. هر درخواست نیز از طریق یک ارکستریتور به مدل مناسب هدایت میشود و این سیستم برای انتخاب مدل، معیارهایی مانند عملکرد، هزینه و دقت را در نظر میگیرد. همچنین گیتهاب کوپایلت Project HydraFusion را ارائه میکند که با استفاده از گردشکارهای چندمدلی، هماهنگی و تخصیص منابع میان مدلهای مختلف را مدیریت میکند. مایکروسافت قصد دارد تا پایان ماه جاری این معماری را یک گام جلوتر ببرد و امکان انتخاب میان مدلهای ابری و مدلهای محلی را به گیتهاب کوپایلت اضافه کند. در این رویکرد، توسعهدهندگان نیازی به مدیریت مستقیم زیرساخت ندارند، چرا که کوپایلت اجرای استنتاج محلی و ابری را به صورت خودکار در پسزمینه هماهنگ خواهد کرد. این قابلیت بهویژه برای لپتاپ سرفیس اولترا مجهز به سختافزار RTX Spark انویدیا اهمیت دارد.
مرتبط: مدل هوش مصنوعی برنامهنویسی آفلاین مایکروسافت منتشر شد
به گفته مایکروسافت، حافظه یکی از مهمترین محدودیتها در اجرای مدلهای هوش مصنوعی روی دستگاه است. این محدودیت علاوه بر حافظه ویدیویی GPU مجزا، حافظه یکپارچهای را نیز شامل میشود که میان CPU و GPU به اشتراک گذاشته میشود. با افزایش context مدل در جریان انجام یک وظیفه و ورود درخواستهای جدید، مصرف منابع افزایش مییابد و زمان پاسخگویی میتواند بیشتر شود. در چنین شرایطی، ظرفیت حافظه برای نگهداری context، همچنین رفتار مدل در سراسر چرخه اجرای وظیفه، بهویژه هنگام مواجهه با محدودیت حافظه، اهمیت زیادی پیدا میکند.
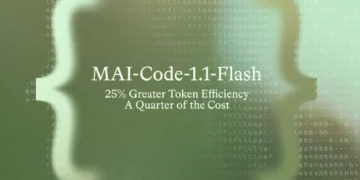
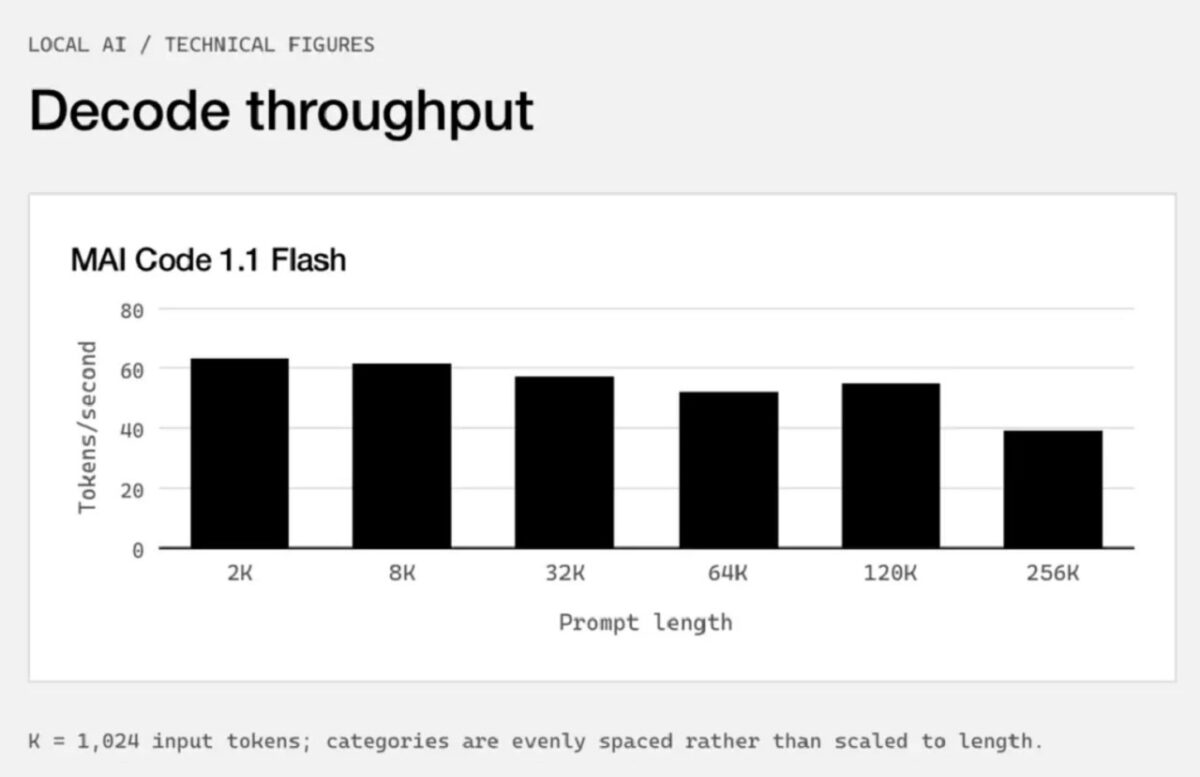
مایکروسافت برای مقابله با این چالش، مدل Mixture of Experts یا MoE جدیدی با نام MAI Code 1.1 Flash معرفی کرده است. این مدل در مجموع ۱۳۷ میلیارد پارامتر دارد، اما تنها ۶.۸ میلیارد پارامتر آن در هر مرحله فعال هستند. مدل مذکور به صورت محلی روی دستگاه اجرا میشود و از تکنیکهایی مانند کوانتیزهسازی و رمزگشایی حدسی برای کاهش footprint مدل و بهبود سرعت پاسخگویی استفاده میکند. مدل MAI Code 1.1 Flash در ابتدا روی لپتاپ سرفیس اولترا عرضه خواهد شد. مایکروسافت عنوان کرد که در مسائل پیچیده، آزمایشهای این شرکت بهبود چشمگیری را در اوج مصرف حافظه و همچنین استفاده، پردازش و بهرهوری توکنها نشان دادهاند.
امنیت مدلها
یکی دیگر از نکات مهم، کنترل بیشتر کاربران گیتهاب کوپایلت بر نحوه استفاده از مدلهای محلی در GitHub Copilot CLI، اپلیکیشن Copilot و Visual Studio Code است. توسعهدهندگان میتوانند گزینه Auto orchestration را انتخاب کنند تا مدیریت زیرساخت و استنتاج بهطور کامل به گیتهاب کوپایلت سپرده شود، یا گردشکارها را به صورت صریح به استفاده از مدلهای روی دستگاه وادار کنند. مایکروسافت توضیح داد که انتخاب صریح مدل محلی برای گردشکارهایی طراحی شده است که به یک ارائهدهنده، مدل یا endpoint مشخص نیاز دارند. توسعهدهندگان میتوانند MAI Code 1.1 Flash را از طریق ارائهدهنده Windows ML انتخاب کنند یا گیتهاب کوپایلت را به endpointهای محلی سازگار با OpenAI متصل نمایند و سپس از میان مدلهایی که این endpointها ارائه میکنند، گزینه مورد نظر را انتخاب نمایند.
بیشتر بخوانید: متا Muse برای آیپد هم منتشر شد
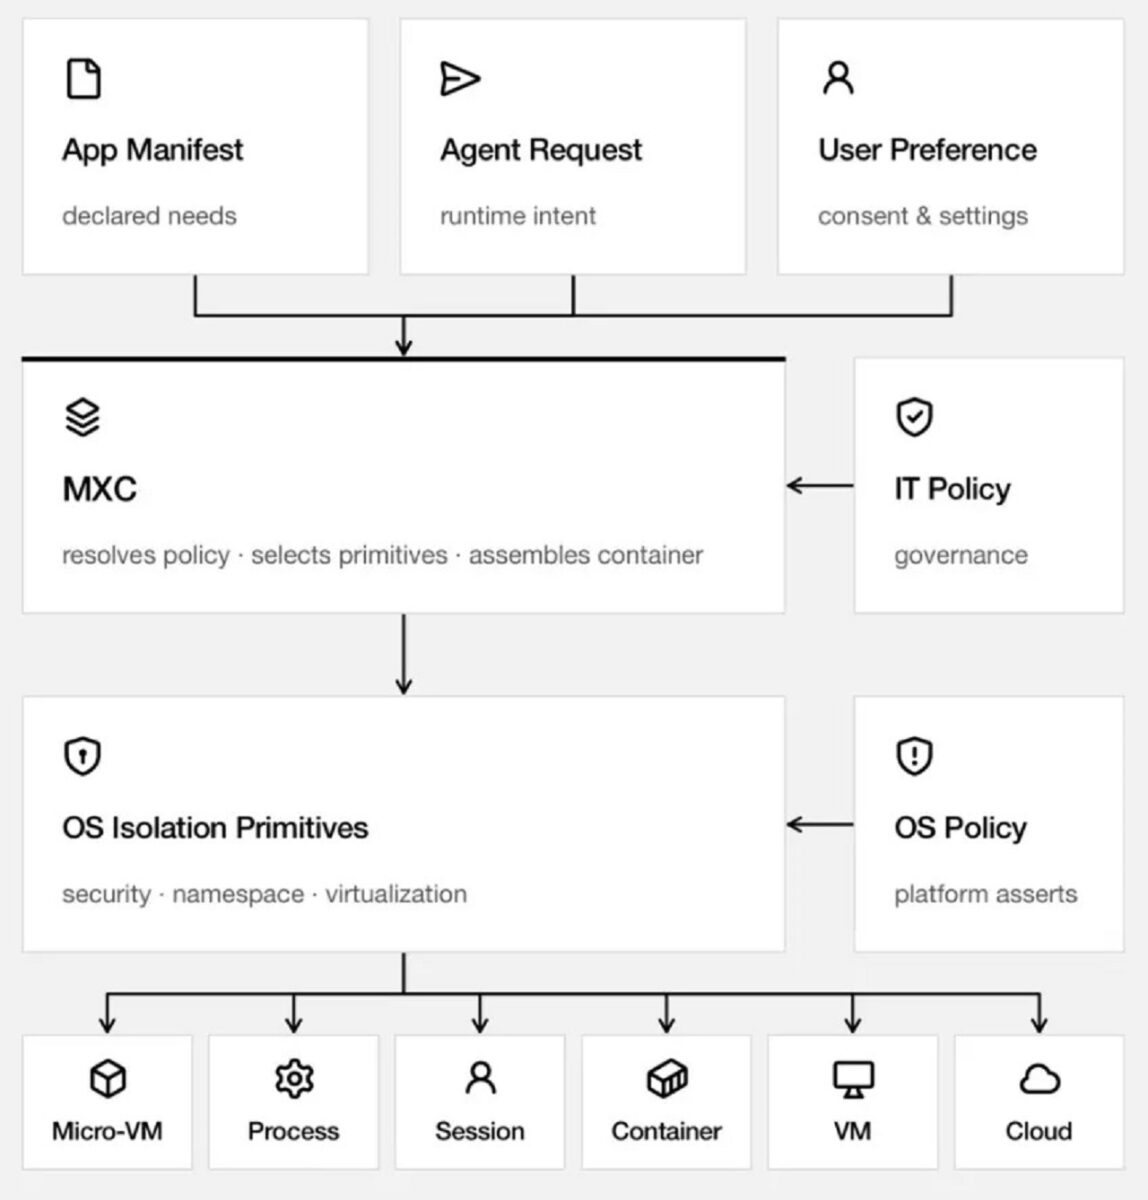
همچنین مایکروسافت درباره امنیت اجرای مدلهای محلی گیتهاب کوپایلت اطمینان داده است. این بخش تحت مدیریت Microsoft Execution Containers یا MXC قرار دارد که توسط تیم ویندوز توسعه یافته و وظیفه آن تبدیل سیاستهای حساب کاربری به کنترلهای بومی سیستمعامل است. MXC در ویندوز از لایه BaseContainer در backend مربوط به ProcessContainer، در لینوکس از bubblewrap و در macOS از Seatbelt استفاده میکند. مایکروسافت در نسخههای آینده نیز قصد دارد گزینههای مبتنی بر ماشین مجازی یا ایمیجهای کانتینری مستقل را به این زیرساخت اضافه کند.