
فهرست مطالب
تیم پژوهشی برجسته Qwen وابسته به Alibaba بار دیگر به صحنه بازگشته و از مدل تصویرساز جدید و بسیار پیشرفتهای با عنوان Qwen-Image رونمایی کرده است. این مدل نیز همچون پروژههای پیشین، بهصورت متنباز در دسترس قرار گرفته است.
به گزارش تکناک، در میان انبوه مدلهای تولید تصویر با هوش مصنوعی، Qwen-Image بهدلیل توانمندی بالا در رندر دقیق متن در تصاویر، جایگاه ویژهای یافته است؛ قابلیتی که بسیاری از مدلهای رقیب هنوز در دستیابی به آن با چالش روبهرو هستند.
ونچربیت مینویسد که این مدل که از نگارشهای الفبایی و لوگوگرافیک پشتیبانی میکند، توانایی بالایی در مدیریت تایپوگرافیهای پیچیده، چیدمان چندخطی، معناشناسی سطح پاراگراف و تولید محتوای دوزبانه (نظیر انگلیسی-چینی) دارد. بهکارگیری آن در عمل، امکان تولید پوستر فیلم، اسلایدهای ارائه، صحنههای فروشگاهی، شعرهای دستنویس و اینفوگرافیکهای سبکدار را با متنی شفاف و منطبق با خواسته کاربر فراهم میکند.
خروجیهای نمونه Qwen-Image شامل طیف متنوعی از کاربردهای واقعی
- بازاریابی و برندینگ: طراحی پوسترهای دوزبانه همراه با لوگوی برند، خوشنویسی هنری و الگوهای طراحی یکپارچه
- طراحی ارائهها: ایجاد اسلایدهای ساختاریافته با سلسلهمراتب عنوانها و تصاویر متناسب با موضوع
- کاربردهای آموزشی: تولید منابع درسی شامل نمودارهای دقیق و متنهای آموزشی با کیفیت بالا
- خردهفروشی و تجارت الکترونیک: طراحی صحنههایی از فروشگاه که خوانایی برچسبها، تابلوها و فضای محیطی در آن حفظ شده است
- محتوای خلاقانه: تولید شعرهای دستنویس، روایتهای تصویری و تصویرسازیهایی به سبک انیمه همراه با متون داستانی تعبیهشده
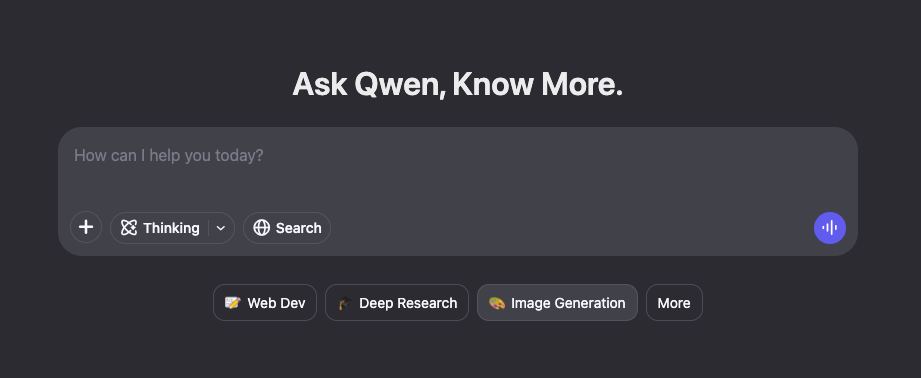
کاربران میتوانند از طریق وبسایت Qwen Chat و انتخاب حالت “Image Generation” از منوی پایین کادر ورودی، بهصورت مستقیم با این مدل تعامل داشته باشند.
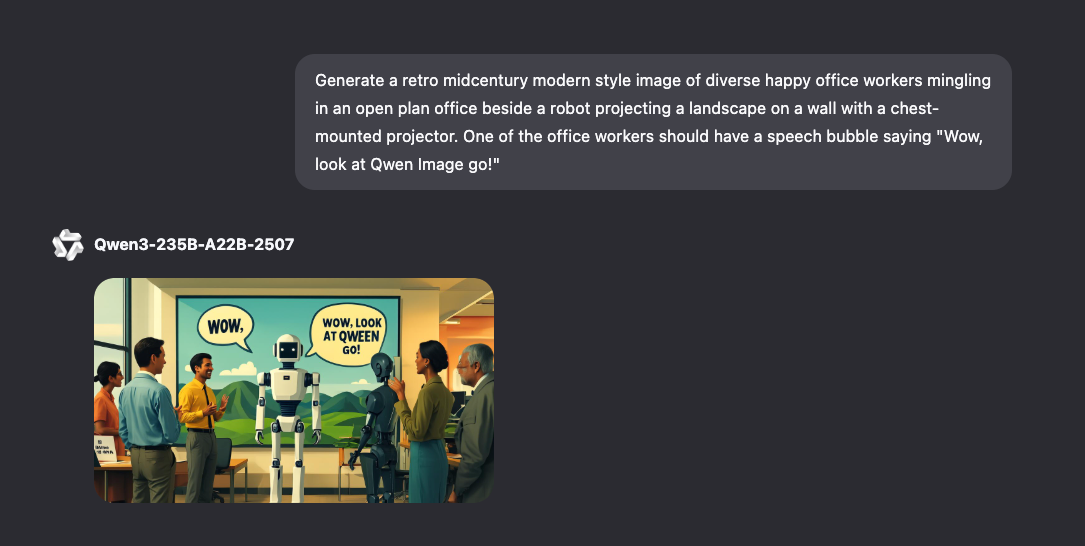
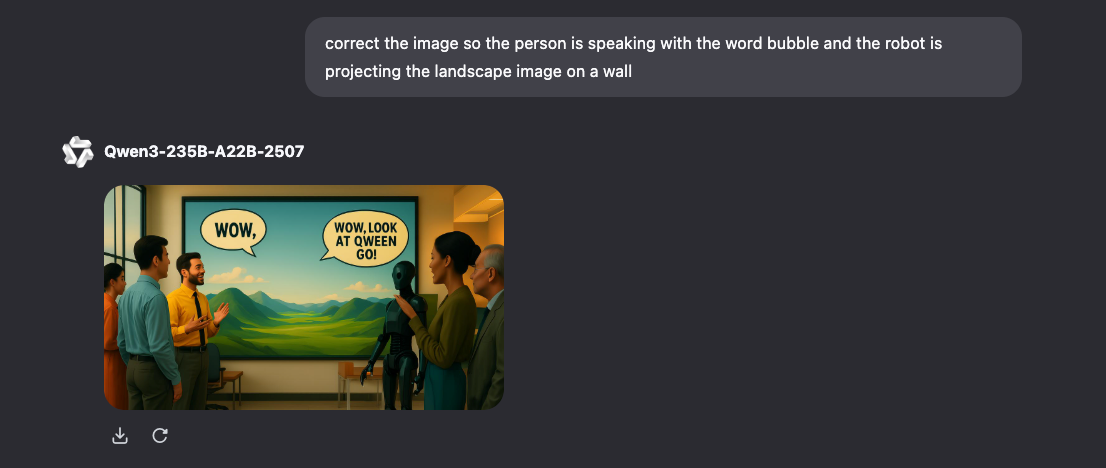
با اینحال، در بررسیهای اولیه نگارنده، تفاوت محسوسی میان Qwen-Image و Midjourney از نظر پایبندی به دستورها و صحت رندر متن مشاهده نشد. تلاشهای مکرر در بازنویسی دستور نیز منجر به بروز خطاهایی در فهم دستور و دقت نوشتاری شد که باعث ناامیدی شد.
البته در مقایسه با Midjourney که تولید رایگان محدودی دارد و برای استفاده بیشتر نیاز به اشتراک دارد، Qwen-Image با تکیه بر مجوز متنباز خود و در دسترس بودن وزنها در Hugging Face، برای شرکتها و توسعهدهندگان ثالث امکان استفاده رایگان و بدون محدودیت را فراهم میآورد.
مجوز و دسترسیپذیری
مدل Qwen-Image تحت مجوز Apache 2.0 عرضه شده است؛ این مجوز اجازه استفاده تجاری و غیرتجاری، بازتوزیع و اصلاح را فراهم میکند، مشروط بر آنکه نسبت به درج اعتبار و متن مجوز در پروژههای مشتقشده اقدام شود.
این مزیت میتواند برای سازمانهایی که به دنبال راهکار تصویرسازی متنباز برای طراحی بروشور، تبلیغات، اطلاعیهها، خبرنامهها و سایر محتوای ارتباطی هستند، بسیار جذاب باشد.
با این وجود، مخفیماندن جزئیات مربوط به دادههای آموزشی مدل — مانند بسیاری دیگر از مدلهای پیشرفته تصویرساز — ممکن است نگرانیهایی را برای برخی سازمانها ایجاد کند.
در مقایسه با Adobe Firefly و GPT-4o، Qwen هیچگونه ضمانت قانونی برای استفاده تجاری از مدل ارائه نمیدهد؛ به بیان دیگر، اگر کاربر بهدلیل نقض حقوق مالکیت فکری مورد پیگرد قضایی قرار گیرد، برخلاف Adobe یا OpenAI، تیم Qwen از کاربر در روند دادرسی پشتیبانی نخواهد کرد.
مدل Qwen-Image و مجموعه ابزارهای جانبی آن شامل دفترچههای نمایشی، ابزارهای ارزیابی و اسکریپتهای تنظیم دقیق، از طریق پلتفرمهای زیر در دسترس قرار دارد:
- Qwen.ai
- Hugging Face
- ModelScope
- GitHub
همچنین یک درگاه ارزیابی زنده با عنوان AI Arena فراهم شده که به کاربران امکان میدهد کیفیت تصاویر تولیدشده را در قالب مقایسههای دوتایی ارزیابی کرده و در رتبهبندی عمومی به سبک Elo مشارکت کنند.
آموزش و توسعه
بر اساس مقاله فنی منتشرشده توسط تیم تحقیقاتی، عملکرد چشمگیر Qwen-Image حاصل فرایند آموزشی گستردهای است که بر پایه یادگیری تدریجی، تطبیق وظایف چندحالته و پالایش دقیق دادهها بنا شده است.
مجموعه دادههای آموزشی این مدل شامل میلیاردها جفت تصویر-متن از چهار حوزه کلیدی است:
- تصاویر طبیعی
- پرترههای انسانی
- محتوای هنری و طراحی (نظیر پوسترها و رابطهای کاربری)
- دادههای مصنوعی با تمرکز ویژه بر متن
هرچند تیم Qwen اندازه دقیق این مجموعه را مشخص نکرده، اما به تفکیک تقریبی محتوای آن اشاره کرده است:
- تصاویر طبیعی: حدود ۵۵٪
- محتوای طراحی و هنری: حدود ۲۷٪
- پرترههای انسانی و فعالیتهای اجتماعی: حدود ۱۳٪
- دادههای مصنوعی متنی: حدود ۵٪
شایان ذکر است که تمامی دادههای مصنوعی بهصورت داخلی تولید شدهاند و از هیچ تصویر تولیدشده توسط مدلهای دیگر استفاده نشده است. همچنین، در مستندات بهصراحت توضیح داده نشده که آیا دادهها دارای مجوز بودهاند یا از منابع عمومی/اختصاصی استخراج شدهاند.
برخلاف بسیاری از مدلهای تصویرساز که بهدلیل خطر نویز، دادههای متنی مصنوعی را نادیده میگیرند، Qwen-Image با بهرهگیری از خطوط تولید مصنوعی کنترلشده، تلاش کرده پوشش کاراکتری بهتری — بهویژه برای نویسههای نادر زبان چینی — ارائه دهد.
فرایند آموزش مدل بهصورت مرحلهای طراحی شده است؛ بهگونهای که ابتدا با تصاویر ساده و بدون متن آغاز شده، سپس به سناریوهای حساس به چیدمان، رندرهای زبانی ترکیبی و پاراگرافهای متراکم گسترش مییابد. این روش تدریجی به مدل امکان میدهد ساختارهای مختلف متنی و زبانی را بهتر تعمیم دهد.
معماری و اجزای مدل
مدل Qwen-Image از سه ماژول اصلی تشکیل شده است:
- Qwen2.5-VL: مدل زبانی چندحالته که معنا را از زمینه استخراج کرده و فرایند تولید تصویر را هدایت میکند
- VAE Encoder/Decoder: آموزشدیده بر اساس اسناد با وضوح بالا و چیدمانهای واقعی، با تمرکز ویژه بر بازنمایی دقیق متون متراکم و عناصر ریز
- MMDiT: هسته مدل انتشار که مسئول هماهنگسازی یادگیری مشترک میان تصویر و متن است؛ همچنین، سیستم رمزگذاری چرخشی مقیاسپذیر چندحالته (MSRoPE) در این بخش برای بهبود تراز فضایی میان توکنها بهکار گرفته شده است
ترکیب این اجزا، Qwen-Image را به ابزاری توانمند برای درک، تولید و ویرایش دقیق تصاویر تبدیل میکند.
ارزیابی عملکرد
مدل Qwen-Image در مقایسه با مدلهای بستهمنبع برجسته نظیر GPT Image 1 [High]، Seedream 3.0 و FLUX.1 Kontext [Pro] در بنچمارکهای عمومی زیر مورد ارزیابی قرار گرفته است:
- GenEval و DPG برای سنجش تبعیت از دستور و هماهنگی ویژگیهای اشیاء
- OneIG-Bench و TIIF برای بررسی منطق ترکیبی و انسجام چیدمان
- CVTG-2K، ChineseWord و LongText-Bench برای سنجش کیفیت رندر متون، بهویژه در زمینههای چندزبانه
در بیشتر موارد، عملکرد Qwen-Image با رقبای بستهمنبع برابری داشته یا از آنها پیشی گرفته است؛ بهویژه در زمینه رندر متون چینی، عملکرد آن چشمگیر بوده است.
در رتبهبندی عمومی AI Arena که مبتنی بر بیش از ۱۰ هزار مقایسه انسانی است، Qwen-Image در جایگاه سوم کلی قرار دارد و بهعنوان برترین مدل متنباز شناخته شده است.
پیامدها برای تصمیمگیرندگان فنی سازمانی
برای تیمهای هوش مصنوعی که مسئول مدیریت جریانهای کاری پیچیده چندحالته در سطح سازمان هستند، Qwen-Image مزایای عملکردی متعددی ارائه میدهد که با نیازهای عملیاتی نقشهای گوناگون همراستا است.
تیمهایی که بر چرخه حیات مدلهای زبانی-تصویری نظارت دارند — از مرحله آموزش تا استقرار — از خروجیهای باکیفیت و اجزای ماژولار مدل بهرهمند میشوند. متنباز بودن آن نیز هزینههای صدور مجوز را کاهش داده و امکان تنظیم مدل بر اساس دادههای خاص سازمانی را فراهم میسازد.
رویکرد آموزشی تدریجی و نتایج بنچمارکهای شفاف نیز به تیمها در ارزیابی تناسب مدل برای کاربردهای خود کمک میکند؛ از تولید محتوای بازاریابی گرفته تا رندر اسناد و طراحی گرافیکی برای محصولات دیجیتال.
مهندسانی که مسئول طراحی زیرساختها یا استقرار مدل در محیطهای توزیعشده هستند، از مستندات دقیق مدل قدردانی خواهند کرد. این مدل با معماری Producer-Consumer آموزش دیده، از پردازش مقیاسپذیر چندرزولوشنه (۲۵۶ تا ۱۳۲۸ پیکسل) پشتیبانی میکند و با Megatron-LM و موازیسازی تنسوری سازگار است. در نتیجه، برای استقرار در زیرساختهای ابری ترکیبی مناسب است.
پشتیبانی از قابلیتهای ویرایش تصویر به تصویر (TI2I) و امکان تولید بر اساس promptهای خاص وظیفه، این مدل را برای استفاده در برنامههای تعاملی یا بلادرنگ نیز مناسب کرده است.
متخصصان حوزه داده نیز میتوانند از Qwen-Image برای تولید دادههای مصنوعی باکیفیت بالا جهت تقویت مدلهای بینایی ماشین، تشخیص شیء یا استخراج چیدمان استفاده کنند.
آموزش مدل برای اجتناب از تولید خروجیهایی با کد QR، متنهای تحریفشده یا واترمارکهای ناخواسته، کیفیت دادههای مصنوعی را افزایش داده و به تیمهای سازمانی کمک میکند تا سلامت مجموعههای آموزشی خود را حفظ کنند.