فهرست مطالب
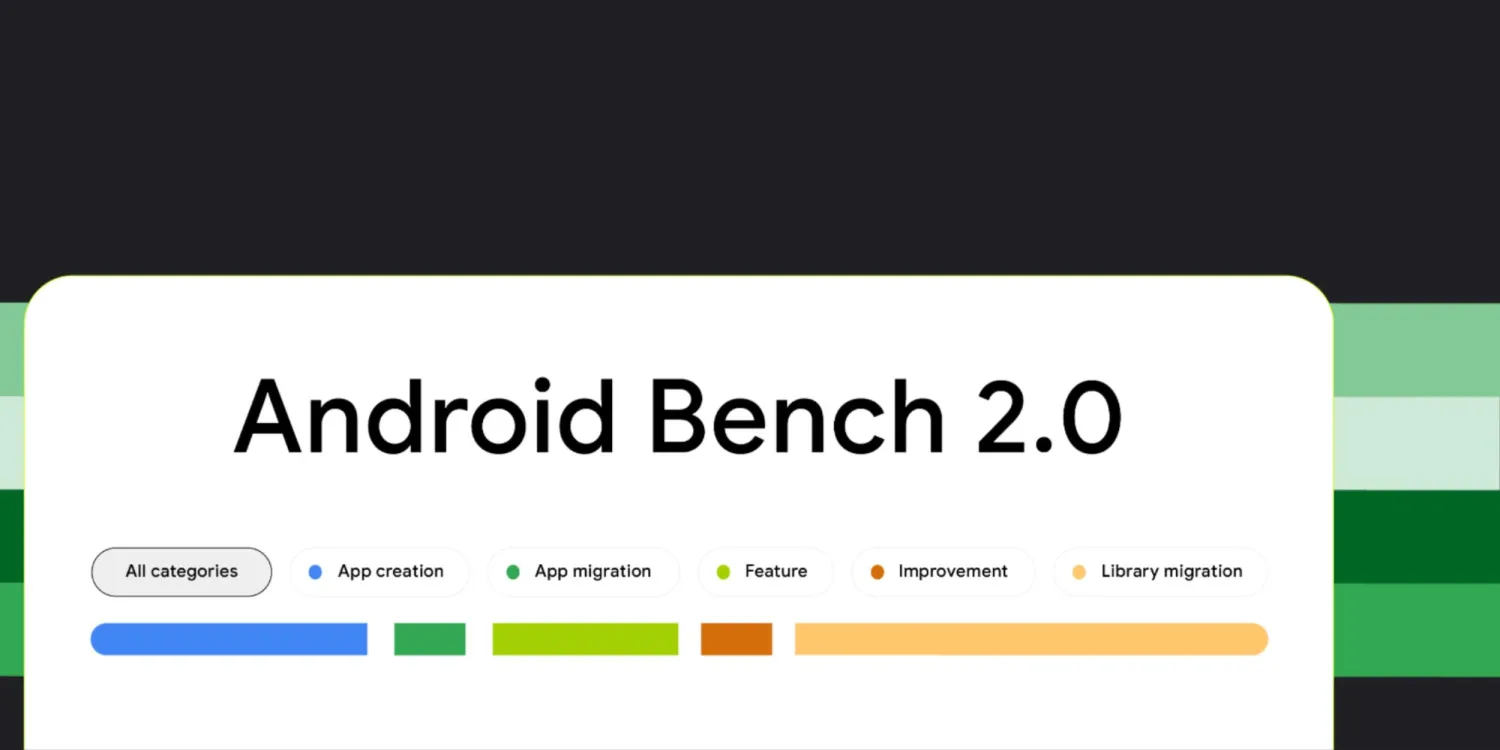
گوگل نسخه 2.0 بنچمارک Android Bench را معرفی کرده است که تمرکز آن از وظایف ساده برنامهنویسی به پروژههای پیچیده و بلندمدت تغییر کرده است.
به گزارش سرویس نرمافزار تکناک، این نسخه علاوه بر سنجش مدلهای هوش مصنوعی، عملکرد عاملهای هوشمند را نیز در محیطهای توسعه واقعیتر بررسی میکند.
نسخه نخست Android Bench بیشتر روی تغییرات محدود در مخازن کد موجود تمرکز داشت. رفع باگها یا اضافه کردن قابلیتهای کوچک از جمله وظایفی بودند که مدلهای هوش مصنوعی در آن ارزیابی میشدند. گوگل در Android Bench 2.0 سطح دشواری را بهطور قابلتوجهی افزایش داده است.
وظایف جدید شامل اضافه کردن قابلیتهای بزرگ، ساخت اپلیکیشن از صفر و تبدیل اپلیکیشنهای چندپلتفرمی به نسخه اندرویدی هستند. به گفته گوگل، انجام برخی از این پروژهها برای یک مهندس نرمافزار ممکن است چند روز یا حتی یک هفته زمان ببرد.
تغییر سیستم امتیازدهی Android Bench
افزایش پیچیدگی وظایف باعث شده است که گوگل روش ارزیابی Android Bench را نیز تغییر دهد. این شرکت دیگر تنها نتیجه قبولی یا مردودی مدل را بررسی نمیکند و از یک سیستم امتیازدهی پیوسته استفاده میکند که میزان موفقیت مدل در بخشهای مختلف هر پروژه را نشان میدهد.
نرخ تکمیل وظایف با عواملی مانند عملکرد صحیح نرمافزار، شباهت بصری خروجی به نتیجه مورد انتظار و جلوگیری از ایجاد مشکلات جدید محاسبه میشود. مدلهایی که از دستورالعملهای ارزیابی یا محدودیتهای ساختاری پروژه فاصله بگیرند نیز با کاهش امتیاز روبهرو میشوند.
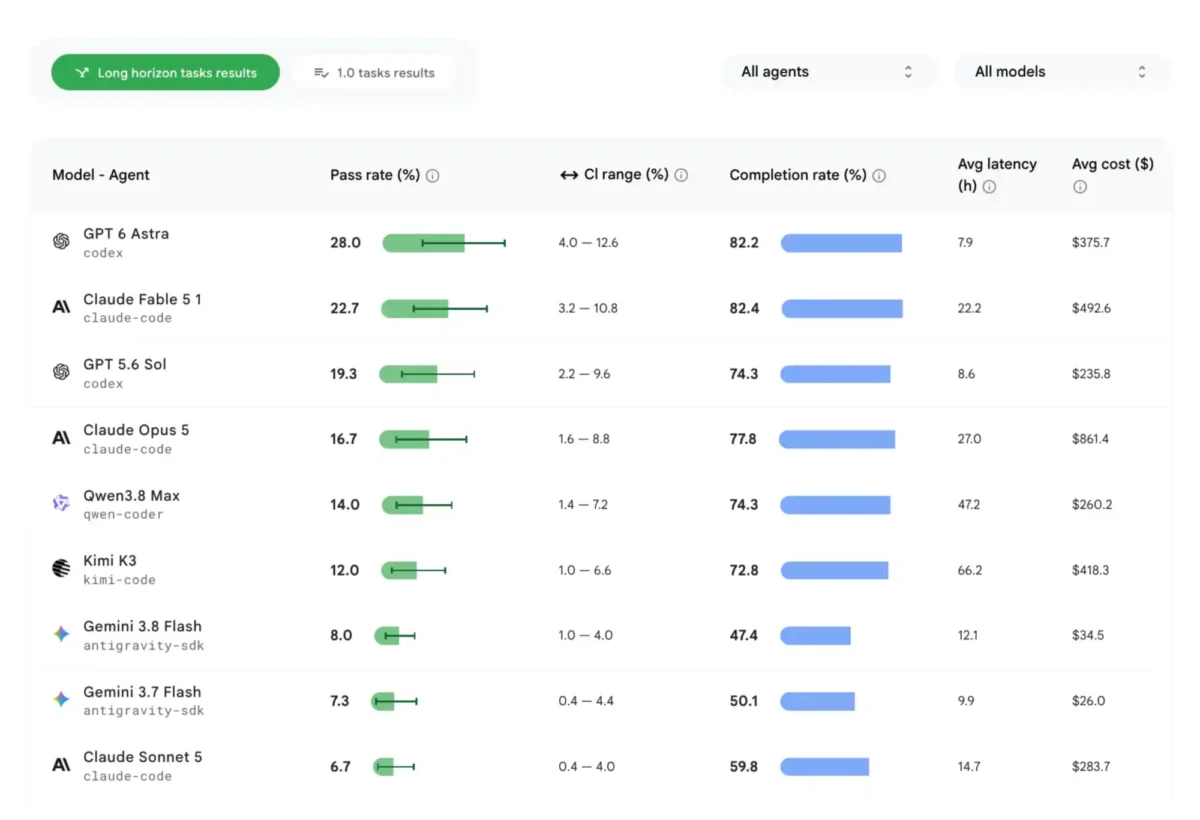
گوگل چند مدل پیشرفته از جمله Gemini 3.7 و Gemini 3.8 Flash، GPT-6، Fable 5.1، Kimi K3 و Qwen 3.8 Max را با این بنچمارک ارزیابی کرده است. GPT-6 Astra با نرخ قبولی ۲۸ درصد در صدر نتایج قرار گرفته است.
این عدد در مقایسه با امتیازهای حدود ۹۰ درصدی مدلها در نسخه قبلی Android Bench بسیار پایینتر است. تفاوت میان این نتایج نشان میدهد که وظایف نسخه 2.0 پیچیدگی بسیار بیشتری دارند و مدلها باید بخش بزرگتری از فرایند توسعه نرمافزار را بهصورت مستقل مدیریت کنند.
چالش مدلها در مهاجرت و بازآرایی کد
نتایج Android Bench نشان میدهد که انتقال اپلیکیشنهای چندپلتفرمی به اندروید همچنان یکی از دشوارترین وظایف برای مدلهای هوش مصنوعی است. هیچ مدلی در این بخش به نرخ قبولی ۱۰۰ درصدی نرسیده است و پیشرفتهترین مدلها حداکثر نرخ تکمیل ۸۰ درصدی را ثبت کردهاند.
بهنوشته 9to5google، گوگل همچنین متوجه شده است که مدلهای هوش مصنوعی در نوشتن کد جدید عملکرد بهتری نسبت به بازآرایی کدهای موجود دارند. پیچیدگی معماری نرمافزار در پروژههای مهاجرت یا بازآرایی نقش مهمتری نسبت به حجم کد ایفا میکند و همین موضوع کار مدلها را دشوارتر میکند.
در مقابل، مدلها در تغییرات مشخص و قابل پیشبینی عملکرد بهتری دارند. تبدیل Java به Kotlin، جایگزینی Retrofit با Ktor و اضافه کردن لایه ViewModel از جمله وظایفی هستند که مدلهای هوش مصنوعی میتوانند با موفقیت بیشتری انجام دهند.
مشکلات اصلی زمانی ظاهر میشوند که پروژه به اعتبارسنجی هنگام اجرا، تغییرات ناسازگار فریمورکها یا اطلاعات مربوط به کتابخانههای منتشرنشده نیاز داشته باشد.
گوگل در Android Bench 2.0 عاملهای هوش مصنوعی را نیز ارزیابی کرده است. Gemini 3.8 Flash روی Google Antigravity و GPT-5.6 Sol با Codex از جمله ترکیبهای آزمایششده هستند. گوگل معتقد است طراحی مناسب محیط اجرای عاملها میتواند نتیجه توسعه نرمافزار را بهبود دهد و قصد دارد در آینده ترکیبهای بیشتری از مدلها و عاملهای هوش مصنوعی را به این بنچمارک اضافه کند.