
فهرست مطالب
مدل متنباز GLM-5.1 از شرکت Z.ai با عملکرد برتر در بنچمارکهای کدنویسی و استدلال و توان اجرای خودکار پروژههای پیچیده، رقبای بزرگی مانند GPT-5.4 و Claude را پشت سر گذاشته است.
به گزارش سرویس هوش مصنوعی تکناک، استارتآپ چینی Z.ai که با نام Zhupai AI نیز شناخته میشود و به عنوان سازنده خانواده مدلهای متنباز GLM شناخته شده است، امروز از انتشار GLM-5.1 تحت مجوز آزاد MIT خبر داد؛ مجوزی که امکان استفاده تجاری، سفارشیسازی و استقرار سازمانی این مدل را از طریق پلتفرمهایی مانند Hugging Face فراهم میکند. این رونمایی در ادامه عرضه GLM-5 Turbo در ماه گذشته انجام شده است؛ مدلی سریعتر که برخلاف نسخه جدید، تحت مجوز اختصاصی ارائه شده بود. مدل GLM-5.1 با رویکرد متفاوتی طراحی شده و قادر است تا ۸ ساعت به صورت خودکار روی یک وظیفه واحد فعالیت کند.
حتما بخوانید: آنتروپیک مدل قدرتمند Mythos را معرفی کرد
این نسخه را میتوان نقطه عطفی در مسیر تکامل مدلهای زبانی دانست؛ جایی که رقبا بیشتر بر افزایش توان استدلالی متمرکز هستند، اما Z.ai مسیر متفاوتی را دنبال کرده و بر «افقهای بهرهوری» تمرکز کرده است. مدل متنباز GLM-5.1 یک معماری Mixture-of-Experts با ۷۵۴ میلیارد پارامتر است که برای حفظ انسجام هدف در مسیرهای اجرایی طولانیمدت بهینهسازی شده است. به گفته «لو»، یکی از مدیران Z.ai در شبکه X، در حالی که نسلهای قبلی عاملهای هوش مصنوعی حدود ۲۰ گام را مدیریت میکردند، GLM-5.1 اکنون به حدود ۱۷۰۰ گام رسیده است. او تاکید کرده است که «توان کار مستقل، شاید مهمترین منحنی پس از قوانین مقیاسپذیری باشد» و این مدل نخستین نقطه قابل سنجش در این مسیر است که جامعه متنباز نیز میتواند آن را راستیآزمایی کند.
شرکت Z.ai در بازار فشرده و رقابتی مدلهای هوش مصنوعی، استراتژی «دونده ماراتن» را انتخاب کرده است. این شرکت که در اوایل ۲۰۲۶ در بورس هنگکنگ با ارزش بازار ۵۲.۸۳ میلیارد دلار عرضه شد، در تلاش است جایگاه خود را به عنوان یکی از پیشروترین توسعهدهندگان مستقل مدلهای زبانی در منطقه تثبیت کند. از منظر فنی، نوآوری اصلی GLM-5.1 در مقیاس آن خلاصه نمیشود (هرچند ۷۵۴ میلیارد پارامتر و پنجره متنی ۲۰۲٬۷۵۲ توکن قابل توجه هستند) بلکه در عبور از «سقف عملکرد» مدلهای پیشین است. در جریانهای کاری عاملمحور سنتی، مدلها معمولا پس از چند بهبود اولیه دچار اشباع عملکرد میشوند و با افزایش زمان یا ابزارها، دچار افت بازده یا انحراف راهبردی میشوند. پژوهش Z.ai نشان میدهد که GLM-5.1 از الگویی موسوم به «پلهای» (staircase pattern) پیروی میکند؛ الگویی مبتنی بر دورههای بهینهسازی تدریجی در یک چارچوب ثابت که با جهشهای ساختاری، سطح جدیدی از توان عملیاتی را فعال میکند. در یکی از سناریوهای گزارش فنی، این مدل برای بهینهسازی یک پایگاه داده برداری با کارایی بالا (VectorDBBench) مورد ارزیابی قرار گرفته است.
بیشتر بخوانید: ظرفیت پردازشی هوش مصنوعی آنتروپیک با TPUهای گوگل افزایش مییابد
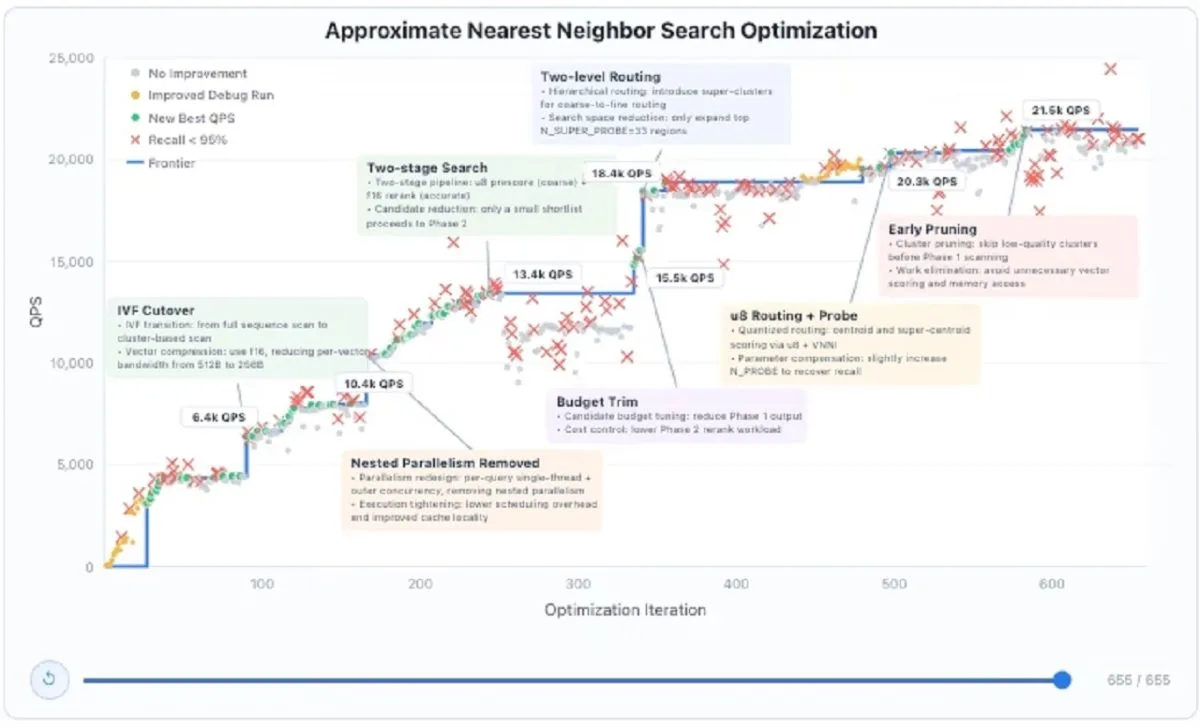
مدل با یک اسکلت کد Rust و بخشهای خالی اولیه ارائه میشود و سپس از طریق عاملهای مبتنی بر tool-call کد را ویرایش، کامپایل، تست و تحلیل عملکرد میکند. در حالی که مدلهای پیشرفته قبلی مانند Claude Opus 4.6 به سقف عملکرد حدود ۳۵۴۷ درخواست در ثانیه رسیده بودند، مدل متنباز GLM-5.1 طی ۶۵۵ تکرار و بیش از ۶۰۰۰ فراخوان ابزار؛ فرایند بهینهسازی را ادامه داد. مسیر بهینهسازی آن خطی نبود و با جهشهای ساختاری همراه بود. مدل در تکرار ۹۰ از اسکن کامل دادهها به سمت بررسی خوشهای IVF با فشردهسازی بردار f16 رفت که پهنای باند هر بردار را از ۵۱۲ به ۲۵۶ بایت کاهش داد و عملکرد را به ۶۴۰۰ درخواست در ثانیه رساند.
این مدل در تکرار ۲۴۰ به صورت خودکار یک پایپلاین دو مرحلهای شامل پیشامتیازدهی u8 و رتبهبندی مجدد f16 ایجاد کرد و به ۱۳٬۴۰۰ درخواست در ثانیه رسید. در نهایت، مدل شش گلوگاه ساختاری را شناسایی و برطرف کرد و با بهینهسازیهایی مانند مسیریابی سلسلهمراتبی و استفاده از centroid scoring، عملکرد را به ۲۱٬۵۰۰ درخواست در ثانیه رساند، که حدود شش برابر بهتر از بهترین نتیجه در یک جلسه ۵۰ مرحلهای بود. این نشان میدهد که مدل مانند یک واحد تحقیق و توسعه مستقل عمل میکند که مسئلههای پیچیده را خرد و با دقت آزمایش میکند.
همچنین مدل توانست زمانبندی اجرا را بهینه کند، سربار را کاهش دهد و locality کش را بهبود بخشد. این مدل در جریان بهینهسازی جستوجوی نزدیکترین همسایه تقریبی، به طور خودکار از معماری موازی تو در تو فاصله گرفت و به طراحی مبتنی بر تکریسمانی برای هر درخواست با همزمانی بیرونی روی آورد. زمانی که دقت مدل به زیر ۹۵ درصد میرسید، آن را تشخیص میداد، پارامترها را تنظیم میکرد و با اصلاحات جبرانی دقت را بازیابی میکرد. این سطح از اصلاح خودکار، تفاوت اصلی GLM-5.1 با مدلهایی است که صرفاً کد تولید میکنند اما آن را در محیط واقعی تست نمیکنند.
پیشروی در مرز یادگیری ماشین
توان پایداری مدل در KernelBench سطح ۳ نیز آزمایش شد؛ جایی که هدف، بهینهسازی end-to-end معماریهایی مانند MobileNet، VGG، MiniGPT و Mamba است. در این چارچوب، مدل باید کرنلی سریعتر از پیادهسازی PyTorch تولید کند، در حالی که خروجیها باید کاملاً یکسان باقی بمانند. هر مسئله در یک کانتینر Docker ایزوله با یک GPU H100 اجرا میشود و محدودیت ۱۲۰۰ فراخوان ابزار دارد. ارزیابی بر اساس صحت و عملکرد نسبت به baseline استاندارد PyTorch در محیط CUDA انجام میشود. نتایج نشان میدهد که شکاف عملکردی قابل توجهی میان GLM-5.1 و نسلهای قبلی وجود دارد. در حالی که GLM-5 اولیه به سرعت بهبود یافت اما در حدود ۲.۶ برابر افزایش سرعت متوقف شد، GLM-5.1 توانست فرایند بهینهسازی را بسیار طولانیتر ادامه دهد. در نهایت به میانگین هندسی ۳.۶ برابر افزایش سرعت در ۵۰ مسئله رسید و حتی پس از ۱۰۰۰ تکرار نیز بهبود معنادار ادامه داشت.
برای مطالعه بیشتر: مدل هوش مصنوعی Muse Spark متا؛ ترکیب متن، تصویر و تصمیمگیری در یک سیستم
با وجود اینکه Claude Opus 4.6 همچنان با ۴.۲ برابر در صدر این بنچمارک قرار دارد، GLM-5.1 دامنه عملکرد موثر مدلهای متنباز را به طور قابل توجهی گسترش داده است. این توانایی به پنجره متنی بزرگتر مربوط نیست؛ بلکه به حفظ همراستایی هدف در اجرای طولانیمدت، کاهش انحراف استراتژی، جلوگیری از تجمع خطا و کنترل آزمونوخطاهای ناکارآمد وابسته است. یکی از دستاوردهای کلیدی، ایجاد حلقه خودکار «آزمایش، تحلیل و بهینهسازی» است، که در آن مدل میتواند به صورت فعال بنچمارک اجرا کند، گلوگاهها را شناسایی نماید، استراتژیها را تغییر دهد و به طور پیوسته عملکرد را بهبود دهد. تمام راهحلهای تولیدشده در این فرایند به طور مستقل برای جلوگیری از سوءاستفاده در بنچمارک بررسی شدهاند تا اطمینان حاصل شود که بهینهسازیها وابسته به الگوهای خاص نبودهاند و در ورودیهای جدید نیز پایدار هستند.
اشتراک و هزینههای مدل متنباز GLM-5.1
مدل GLM-5.1 به عنوان یک ابزار سطح مهندسی و نه یک چتبات مصرفی عرضه شده است. در همین راستا، Z.ai آن را در قالب یک اکوسیستم اشتراکی Coding Plan ارائه کرده است، که با ابزارهای توسعه پیشرفته رقابت میکند. این محصول در سه سطح اشتراک ارائه میشود و هر سه شامل ابزارهای رایگان MCP برای تحلیل تصویر، جستوجوی وب، خواندن صفحات وب و پردازش اسناد هستند. سطح Lite با قیمت ۲۷ دلار در هر فصل برای کارهای سبک طراحی شده است و سه برابر استفاده بیشتر نسبت به Claude Pro ارائه میدهد. سطح Pro با قیمت ۸۱ دلار در هر فصل برای بارهای کاری پیچیده است و ۵ برابر ظرفیت Lite و ۴۰ تا ۶۰ درصد سرعت اجرای بالاتر دارد.
سطح Max با قیمت ۲۱۶ دلار در هر فصل برای توسعهدهندگان حرفهای با حجم کاری بالا طراحی شده است و عملکرد پایدار را در ساعات اوج تضمین میکند. برای استفاده API مستقیم یا از طریق پلتفرمهایی مانند OpenRouter و Requesty، قیمتگذاری GLM-5.1 برابر ۱.۴۰ دلار برای هر یک میلیون توکن ورودی و ۴.۴۰ دلار برای هر یک میلیون توکن خروجی است. همچنین تخفیف کش با قیمت ۰.۲۶ دلار برای هر یک میلیون توکن ورودی در نظر گرفته شده است.
شکلگیری یک معیار جدید در رقابت جهانی با مدل متنباز GLM-5.1
مرتبط: امکان ساخت شبیهسازیها و مدلهای سهبعدی تعاملی به چتبات Gemini اضافه شد
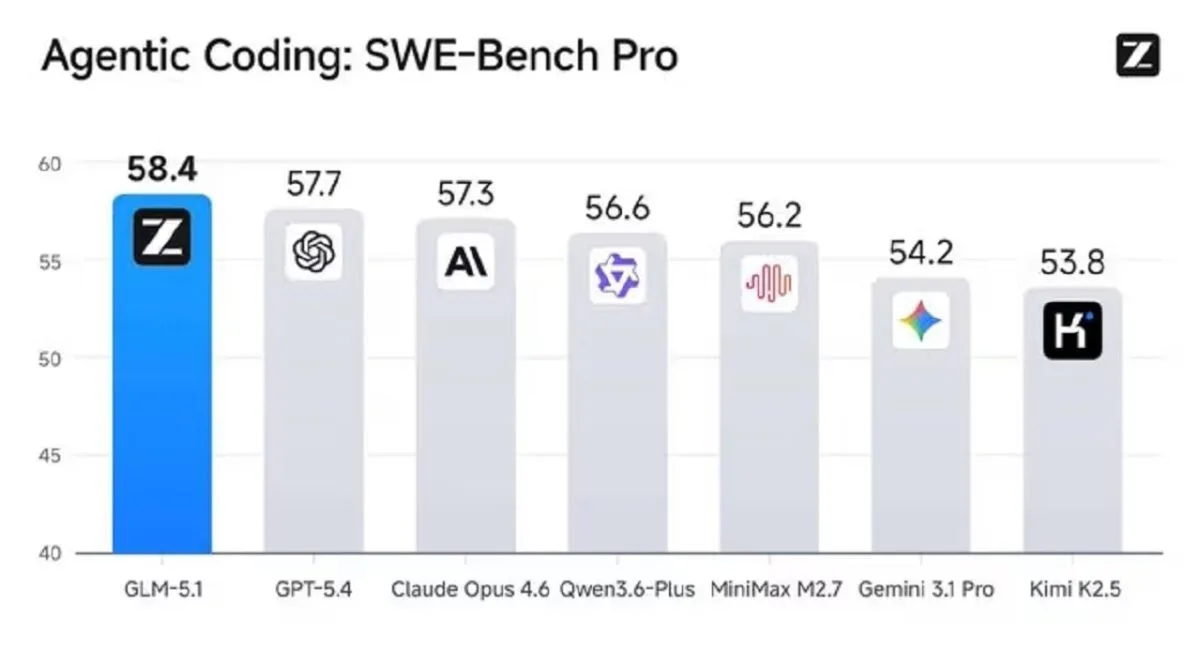
ارزیابیهای عملکردی GLM-5.1 نشان میدهد که این مدل در چندین بنچمارک کلیدی مهندسی و کدنویسی موفق شده است از مدلهای مطرح غربی عبور کند. در SWE-Bench Pro (که توانایی حل مسائل واقعی مخازن GitHub را با ورودیهای پیچیده و پنجره متنی ۲۰۰ هزار توکن میسنجد) این مدل به امتیاز ۵۸.۴ دست یافته، که بالاتر از GPT-5.4 با ۵۷.۷، Claude Opus 4.6 با ۵۷.۳ و Gemini 3.1 Pro با ۵۴.۲ است. در سایر بنچمارکهای عاملمحور نیز روند مشابهی دیده میشود. در حوزه استدلال عمومی، مدل در Humanity’s Last Exam امتیاز ۳۱.۰ کسب کرده که با استفاده از ابزارهای خارجی به ۵۲.۳ ارتقا یافته است. در AIME 2026 به ۹۵.۳ و در GPQA-Diamond به ۸۶.۲ رسیده است؛ اعدادی که آن را در رده بالای استدلال علمی و ریاضی قرار میدهد. نمایش شاخص این توانایی، سناریوی تولید یک محیط دسکتاپ شبهلینوکس در بازه ۸ ساعته بوده است. برخلاف نسلهای پیشین که به خروجیهای ابتدایی و سطحی بسنده میکردند، این مدل توانسته است اجزای کامل شامل فایلمنیجر، ترمینال، ادیتور متن، مانیتور سیستم و حتی بازیهای کاربردی را تولید کند و به صورت چرخهای به بهینهسازی تجربه کاربر ادامه دهد.
لایسنس و معماری بازار
مدل متنباز GLM-5.1 تحت مجوز MIT منتشر شده و وزنهای آن در Hugging Face و ModelScope در دسترس قرار گرفته است. در مقابل، GLM-5 Turbo همچنان به صورت بسته و تجاری باقی مانده است؛ الگویی که نشاندهنده گذار صنعت به سمت مدلهای دوگانه، شامل متنباز برای توسعه اکوسیستم و نسخههای بهینهشده برای درآمدزایی است. این رویکرد در حال تبدیل شدن به روند غالب در بازار چین نیز میباشد، جایی که بازیگران بزرگ در حال تفکیک خطوط متنباز و محصولات تجاری خود هستند. در این چارچوب، شرکت تلاش دارد ضمن باز نگه داشتن هسته مدل، مزیت رقابتی خود را در لایههای اجرایی و بهینهسازیشده حفظ کند.
واکنش اکوسیستم توسعهدهندگان
بازخورد جامعه توسعهدهندگان بر قابلیت اطمینان در محیطهای تولیدی متمرکز بوده است. گزارشها نشان میدهد که این مدل نیاز کمتری به تنظیم پرامپت دارد و در مقایسه با رقبا رفتار قابل پیشبینیتری در اجرای وظایف پیچیده ارائه میدهد. در مواردی نیز چرخه کامل پروژه (از برنامهریزی تا اجرا) با حداقل مداخله انسانی انجام شده است. یک مطالعه موردی نشان میدهد فرایندی که به طور معمول یک هفته زمان نیاز داشت، شامل پیشپردازش کد و تنظیم مدلهای یادگیری ماشین، در دو روز تکمیل شده است. در شبکههای اجتماعی، انتشار این مدل با بیش از ۴۶ هزار بازدید در ساعت نخست همراه شد و تمرکز اصلی کاربران بر قابلیت اجرای مستقل ۸ ساعته آن بود. جمعبندی اولیه جامعه این است که این نسل از مدلها وارد مرحلهای شدهاند که در آن «تکرار و اصلاح خودکار» جایگزین تولید صرف متن شده است.
پیشنهادی: با انتشار نسخه جدید Claude Code بیش از ۵۰۰ هزار خط کد آنتروپیک لو رفت
از پاسخگویی به اجرای مستقل
مدل متنباز GLM-5.1 نشان میدهد که محور رقابت در هوش مصنوعی در حال انتقال از سرعت پردازش به «بازه اجرای مستقل» است. توانایی انجام کار پیوسته ۸ ساعته بدون مداخله انسانی، چرخه توسعه نرمافزار را از اساس بازتعریف میکند. با وجود این، چالشهای بنیادین همچنان پابرجا است، که از جمله آنها میتوان به طراحی سیستمهای self-evaluation در نبود معیار عددی، جلوگیری از همگرایی به بهینههای محلی و حفظ انسجام در مسیرهای اجرایی بسیار طولانی اشاره کرد. پشتیبانی از ابزارهای توسعه متعدد مانند Claude Code، Cline و Roo Code نشان میدهد که این مدلها از مرحله تولید پاسخ عبور کردهاند و وارد حوزه «اجرای پروژههای کامل» شدهاند. در این چارچوب، پرسش کلیدی صنعت تغییر یافته است: دیگر مسئله این نیست که یک مدل چه پاسخی میدهد، بلکه این است که چه میزان کار مستقل را میتواند در یک بازه زمانی ممتد به انجام برساند.