فهرست مطالب
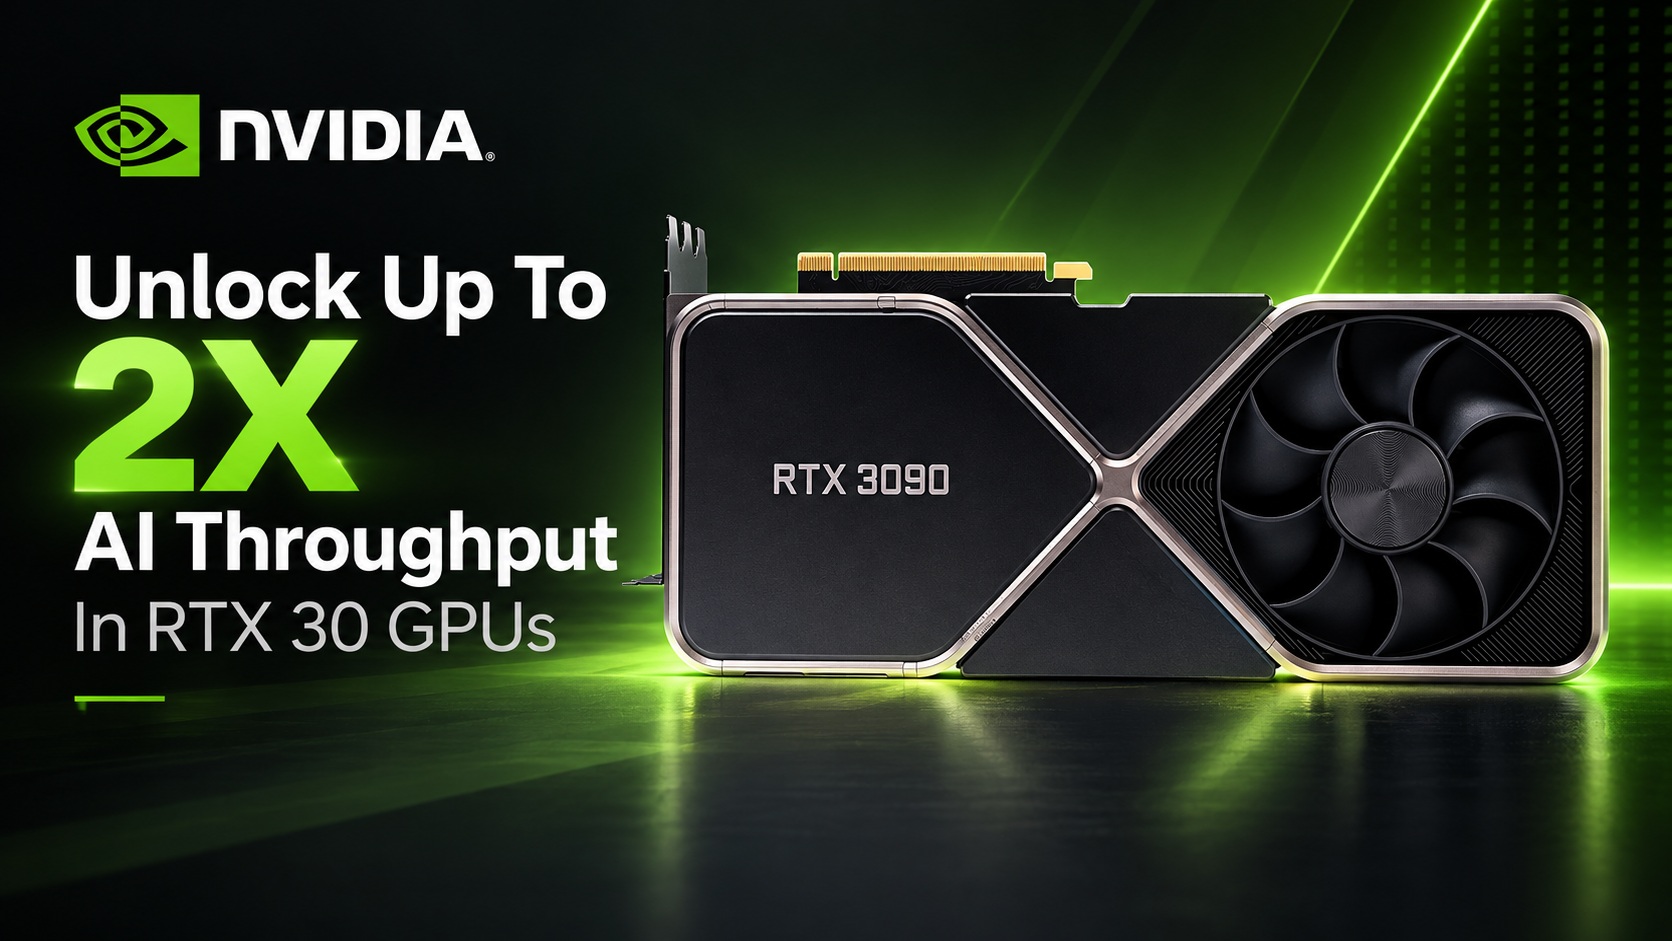
ابزار متنباز GPU Unlock با دور زدن برخی محدودیتهای کارت گرافیک RTX 30 انویدیا، توان پردازش هوش مصنوعی را در بعضی بارهای کاری تا حدود دو برابر افزایش میدهد.
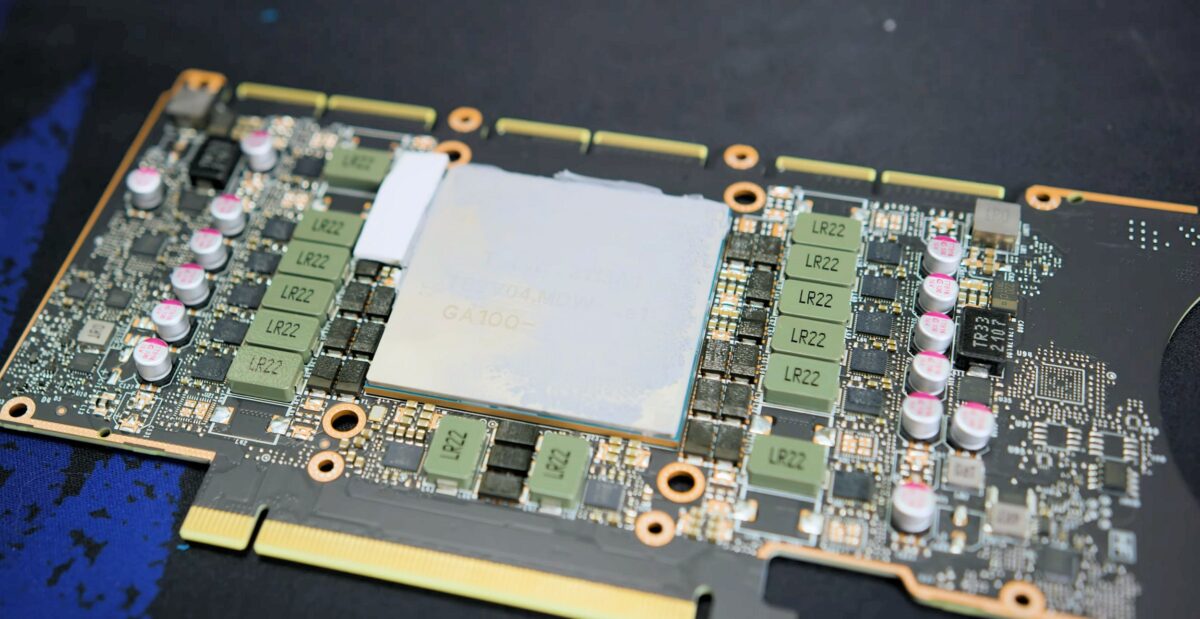
به گزارش سرویس سختافزار تکناک، کارتهای گرافیک نسل GeForce RTX 30 انویدیا با معماری Ampere، با وجود گذشت چند نسل از زمان عرضه، هنوز از ظرفیت محاسباتی استفادهنشدهای برخوردار هستند. پروژه متنباز GPU Unlock که توسط کاربر گیتهاب Zagitta توسعه یافته است، امکان عبور پردازندههای گرافیکی Ampere از برخی محدودیتهای مصنوعی عملکرد را فراهم میکند و در بارهای کاری مشخص، توان محاسباتی Tensor Coreها را بدون نیاز به استفاده از درایور دستکاریشده انویدیا یا فلش دائمی VBIOS تقریبا دو برابر افزایش میدهد.
بیشتر بخوانید: کارتهای گرافیک قدیمی به داراییهای باارزش و سودآور تبدیل میشوند
نحوه عملکرد ماد GPU Unlock
این پروژه بهطور خاص محدودیت نرخ صدور دستورها را در عملیات Tensor Core با قالبهای FP16 و BF16 و انباشت FP32 هدف قرار میدهد. این محدودیت باعث میشود عملیات مذکور در کارتهای گرافیک مصرفی مبتنی بر معماری Ampere با نرخ پایینتری نسبت به مدلهای حرفهای اجرا شوند. GPU Unlock با حذف این محدودیت، توان محاسباتی بیشتری را فعال میکند که از نظر سختافزاری از ابتدا در این پردازندههای گرافیکی وجود داشته است.
در عین حال GPU Unlock از پژوهشهای پیشین درباره کارتهای گرافیک CMP انویدیا، طراحیشده برای استخراج رمزارز بهره میگیرد. این پروژه تکنیکهای آزادسازی میانافزار در پروژه CMP را با رویکردی مبتنی بر مقداردهی اولیه پیش از بارگذاری درایور ترکیب میکند. در این فرایند، یک ماژول هسته لینوکس پیش از بارگذاری درایور گرافیکی انویدیا اجرا میشود، انتخابگرهای سختافزاری مرتبط با سرعت پردازش را تغییر میدهد و سپس یک بازنشانی در سطح عملکرد (FLR) انجام میدهد. پس از این مراحل، درایور اصلی انویدیا بدون هیچ تغییری میتواند پردازنده گرافیکی را بهطور معمول مقداردهی اولیه کند.
برای مطالعه بیشتر: کارتهای گیمینگ RTX 5090 به سختافزار هوش مصنوعی در چین تبدیل میشوند
یکی از مزیتهای این روش آن است که کاربران برای استفاده از نسخههای جدید درایور انویدیا نیازی به وصله کردن مجدد آنها ندارند. توسعهدهنده در حال حاضر پشتیبانی از پردازندههای گرافیکی GA102، GA103، GA104 و GA106 را اعلام کرده است؛ مجموعهای که بخش بزرگی از محصولات سری GeForce RTX 30 را پوشش میدهد. با وجود این، سازگاری و میزان افزایش عملکرد در تمام مدلهای این خانواده تضمینشده نیست.
افزایش قدرت به کارت RTX 30 انویدیا محدود نمیشود
افزایش عملکرد گزارششده به RTX 3090 Ti محدود نمیشود. یکی از دارندگان RTX 3080 Ti اعلام کرده است که توان عملیاتی محاسبات BF16 از ۷۱٫۵۹ به ۱۱۳٫۹۸ ترافلاپس و عملکرد TF32 از ۳۵٫۶۵ به ۶۵٫۲۸ ترافلاپس افزایش یافته است؛ آن هم در شرایطی که توان مصرفی GPU به ۳۱۵ وات محدود بوده است. گزارش دیگری درباره سازگاری RTX 3080 با حافظه ۱۰ گیگابایتی نیز از افزایش عملکرد FP16 و BF16 از حدود ۶۵ ترافلاپس به محدوده ۱۱۰ تا ۱۱۳ ترافلاپس حکایت دارد. این نتیجه با حفظ سقف توان پیشفرض ۳۲۰ وات کارت به دست آمده است. این بهبودها در شبکه اجتماعی X نیز بازتاب داشتهاند. با وجود این، پرسش مهمتر به عملکرد GPU Unlock در کاربردهای واقعی مربوط میشود. کاربران جامعه متنباز آزمایش این ابزار را در بارهای کاری عملی هوش مصنوعی آغاز کردهاند و نتایج اولیه از بهبودهای قابل توجهی حکایت دارند.
یکی از دارندگان RTX 3090 Ti در ردیت، GPU Unlock را در محیط ComfyUI ارزیابی کرده است. بر اساس گزارش او، توان عملیاتی پردازش با مدل MOSS-Image SFT BF16 به میزان ۵۸٫۶ درصد، با Qwen-Image 2.1 Turbo BF16 به میزان ۵۷٫۲ درصد و با Z-Image Turbo BF16 به میزان ۵۶٫۱ درصد افزایش یافته است. در مقابل، پیکربندیهای INT8 بهبود بسیار محدودتری نشان دادهاند و افزایش عملکرد MOSS-Image SFT INT8 تنها ۰٫۳ درصد بوده است. همچنین آزمایشکننده تأیید کرده که خروجی تصاویر رمزگشاییشده در پیکربندی استاندارد و پیکربندی مجهز به GPU Unlock یکسان بوده است.
حتما بخوانید: انویدیا با اتصال ۵۷۶ پردازنده گرافیکی Rubin Ultra، غول هوش مصنوعی میسازد + تصویر
استنتاج مدلهای زبانی بزرگ (LLM) نیز یکی دیگر از کاربردهایی است که ممکن است از این ابزار بهره ببرد، هرچند میزان بهبود بهشدت به ماهیت بار کاری بستگی دارد. برای مثال، گزارشی درباره سازگاری کارت RTX 3090 انویدیا از افزایش ۳۳ درصدی توان عملیاتی پردازش پرامپت و استنتاج در vLLM خبر میدهد، درحالیکه سرعت تولید توکن تقریبا ثابت مانده است. این تفاوت قابل انتظار است، زیرا مرحله رمزگشایی در بسیاری از مدلهای زبانی بزرگ بیشتر با محدودیت پهنای باند حافظه مواجه است تا با کمبود توان محاسباتی خام Tensor Coreها مواجه باشد.
در همین حال، پیادهسازی آزمایشی دیگری برای ویندوز توسعه یافته است که بهجای ماژول هسته لینوکس در نسخه اصلی، از رویکرد مبتنی بر UEFI استفاده میکند. توسعهدهنده این نسخه، اجرای موفق آن روی RTX 3090 را مستند کرده و از افزایش حدود ۸۲٫۵ درصدی توان محاسباتی BF16 خبر داده است. هرچند، این راهکار همچنان آزمایشی و مختص پیکربندیهای سختافزاری مشخص است و هنوز نمیتوان آن را نسخهای عمومی با سازگاری گسترده در ویندوز به حساب آورد.
البته GPU Unlock با محدودیتهای مهمی همراه است. این ابزار پهنای باند حافظه را افزایش نمیدهد، هستههای CUDA اضافی را فعال نمیکند و تضمینی برای بهبود عملکرد تمام بارهای کاری ارائه نمیدهد. در یک گزارش سازگاری مربوط به RTX 3080 Ti با حافظه ۲۰ گیگابایتی، فرایند آزادسازی محدودیتها با موفقیت انجام شده بود، اما افزایش مورد انتظار در عملکرد BF16 مشاهده نشد. این نمونه نشان میدهد که نتیجه استفاده از ابزار در همه پیکربندیها یکسان نیست.
در حوزه بازی نیز با وجود استفاده فناوریهای DLSS انویدیا از Tensor Coreها، هنوز شواهد قانعکنندهای مبنی بر افزایش عملکرد بازیها یا کاهش زمان اجرای DLSS با GPU Unlock وجود ندارد. دستیابی به بهبود عملکرد مستلزم آن است که بار کاری مورد نظر واقعا از دستورها و حالتهای انباشت تحت تاثیر این ابزار استفاده کند. در نتیجه، افزایش چشمگیر توان محاسباتی در بنچمارکها را نباید معادل افزایش مشابه نرخ فریم در بازیها دانست.
با وجود این ملاحظات، GPU Unlock پیشرفت قابل توجهی برای دارندگان سری کارت گرافیک GeForce RTX 30 انویدیا محسوب میشود؛ بهخصوص برای کاربرانی که از GPU خود برای استنتاج محلی هوش مصنوعی، تولید تصویر و سایر کاربردهای محاسباتی سنگین استفاده میکنند. اگرچه این پروژه هنوز آزمایشی است، امکان استخراج توان پردازشی بهمراتب بیشتر از سختافزار موجود، بدون دستکاری دائمی آن، مزیتی چشمگیر به حساب میآید.