
فهرست مطالب
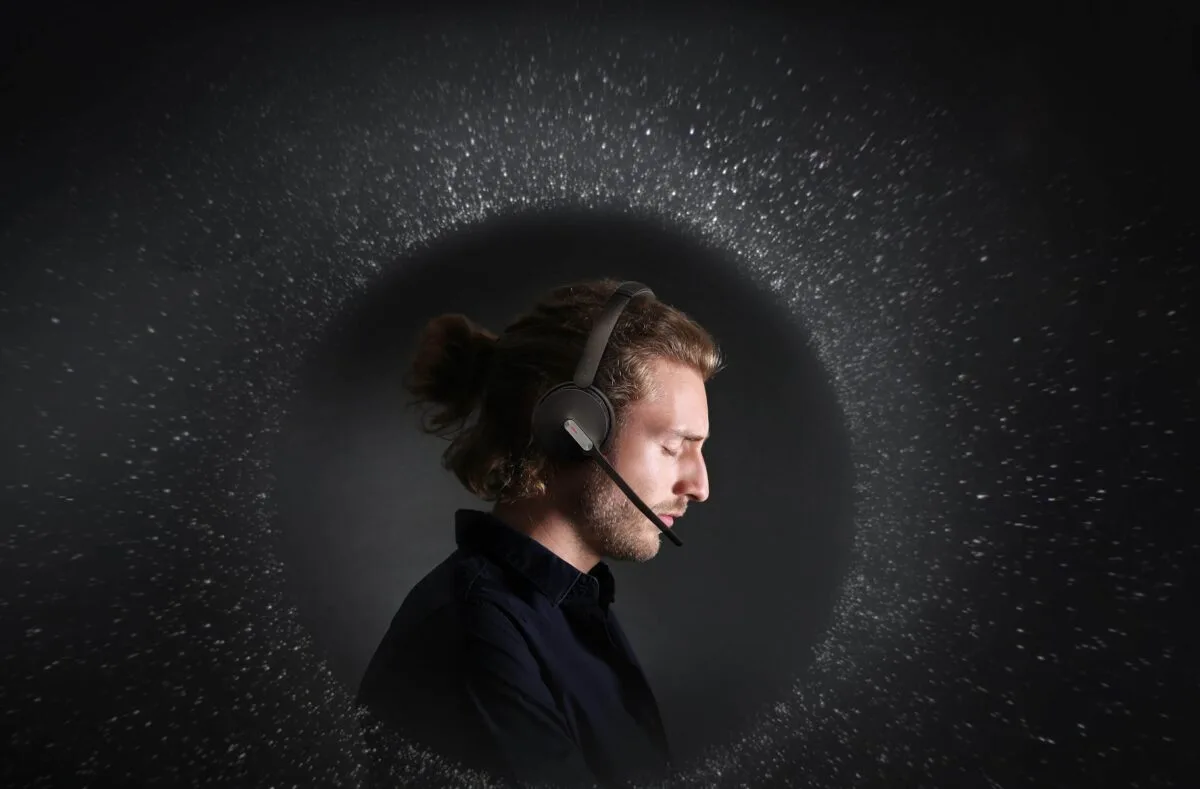
هدفون مبتنی بر هوش مصنوعی دانشگاه واشینگتن قادر است مکالمه را از نویز محیط جدا کند و تجربه شنیداری را به طور چشمگیری بهبود بخشد.
به گزارش سرویس کامپیوتر و موبایل تکناک، در محیطهای شلوغ، بین موسیقی، صدای ظروف و گفتوگوهای همزمان، تمرکز روی یک صدا سخت است و برای افراد دارای مشکل شنوایی این کار بسیار سنگینتر میشود.
حتما بخوانید: این هدفون ۳۷۰ میلیون تومان قیمت دارد
تکنولوژی هدفون مبتنی بر هوش مصنوعی
اکنون نسخه آزمایشی هدفون دانشگاه واشینگتن بدون نیاز به دخالت کاربر، مکالمه را خودکار تشخیص میدهد و صداهای خارج از الگوی نوبتی گفتوگو را خاموش میکند. دو مدل هوش مصنوعی، یکی بر اساس زمانبندی و دیگری برای حذف نویز، همکاری میکنند تا مشارکتکنندگان را ظرف دو تا چهار ثانیه شناسایی کنند. این پژوهش که در هفتم نوامبر در سوزو چین ارائه شد، میتواند مسیر تازهای برای توسعه سمعکها، هدفونها و عینکهای هوشمند بگشاید.
بیشتر بخوانید: سنهایزر هدفون بیسیم HDB 630 را با فرستنده تطبیقی با وضوح درخورتوجه رونمایی کرد
برای مطالعه بیشتر: این هدفون لوکس از آیفون هم گرانتر است
شیام گولاکوتا، نویسنده ارشد مقاله بیان کرد که روشهای قدیمی برای شناسایی مکالمه به الکترودهای کاشتهشده در مغز متکی بودند، اما الگوهای طبیعی مکالمه راه سادهتری ارائه میدهند. او توضیح داد که گفتوگوها ریتم نوبتی دارند و هوش مصنوعی میتواند این ریتمها را با صوت و بدون نیاز به کاشت تجهیزات، پیشبینی و دنبال کند. هدفون هوشمند همزمان با آغاز صحبت کاربر فعال میشود؛ ابتدا با بررسی زمانبندی گفتوگو مشخص میکند که چه کسی سخن گفته است و میزان همپوشانی صداها را میسنجد و سپس با پالایش سیگنال، صدای تفکیکشده را به صورت آنی به کاربر بازمیگرداند.
نسخه آزمایشی قادر است مکالمات بین کاربر و چهار نفر دیگر را بدون تاخیر محسوس مدیریت کند. در ارزیابی انجامشده با ۱۱ شرکتکننده، وضوح صدا، کاهش نویز و میزان فهم گفتوگو در حالت فیلترشده بیش از دو برابر حالت عادی گزارش شد.
از هدفون تا سمعک
این هدفون مبتنی بر هوش مصنوعی ادامه تلاشهای پیشین تیم گولاکوتا است، اما برخلاف نمونههای قبلی که نیازمند انتخاب دستی گوینده یا تنظیم فاصله بودند، طراحی جدید تمام این مراحل را حذف و به صورت خودکار عمل میکند. این فناوری «پیشفعال» است و بدون دخالت کاربر، نیت انسانی را استنتاج میکند. با وجود این، مکالمات آشفته، قطع کردن سخن و ورود ناگهانی افراد همچنان چالشهایی برای ردیابی ایجاد میکند. با وجود این، نتایج اولیه برای تیم بسیار امیدوارکننده بوده است. مدلها بر اساس زبان انگلیسی، ماندرین و ژاپنی آموزش دیدهاند و به احتمال زیاد برای زبانهای دیگر نیاز به تنظیم دارند. نسخه فعلی بر پایه هدفونهای بزرگ تجاری و مدارهای ساده توسعه یافته، اما گولاکوتا معتقد است این فناوری بهزودی در قالب ایرپادها یا سمعکهای کوچک عرضه خواهد شد.
این پژوهش در وبسایت ACL Anthology منتشر شده است.