شرکت انویدیا با استفاده از پردازندههای گرافیکی Blackwell و معماری NVFP4، آماده پشتیبانی از مدلهای پیشرفته هوش مصنوعی نظیر DeepSeek-V4 است.
به گزارش سرویس هوش مصنوعی تکناک، نسخه چهارم DeepSeek با مجموعهای از بهینهسازیهای چشمگیر معرفی شده است؛ بهینهسازیهایی که امکان اجرای مدلهایی با ابعاد ۱.۶ تریلیون پارامتر را فراهم میکنند. در همین راستا، انویدیا نیز با ارائه پشتیبانی Day-0 روی پردازندههای گرافیکی Blackwell، آمادگی کامل خود را برای این نسل جدید اعلام کرده است.
معماری NVFP4 در Blackwell نقش کلیدی در افزایش سرعت پردازش DeepSeek V4 ایفا میکند و طبق اعلام انویدیا، این تنها آغاز مسیر بهینهسازیها است. عرضه این نسخه با کاهش چشمگیر نیازهای محاسباتی و مصرف حافظه همراه بوده و کارایی کلی سیستم را به طور محسوسی ارتقا داده است.
بیشتر بخوانید: دستیار صوتی سیری به مدل های هوش مصنوعی جمنای مجهز می شود
بر اساس اطلاعات منتشرشده، DeepSeek-V4 برای استنتاج تکتوکن تنها به ۲۷ درصد از توان محاسباتی قبلی (FLOPs) نیاز دارد و در سناریوی پنجره متنی یک میلیون توکنی، مصرف KV Cache به ۱۰ درصد کاهش یافته است. انویدیا در این معرفی، عملکرد Blackwell را به عنوان زیرساختی کلیدی برای اجرای مدلهای عظیم و پردازشهای با زمینه طولانی، برجسته کرده است و تاکید دارد که این پردازندهها با تاخیر پایین، بستر لازم را برای اجرای مدلهای تریلیونپارامتری DeepSeek-V4 از همان روز نخست فراهم میکنند.
شرکت انویدیا با پوشش کامل زنجیره توسعه تا استقرار، از پیادهسازی در مراکز داده مبتنی بر Blackwell گرفته تا ارائه میکروسرویسهای مدیریتشده NIM و جریانهای کاری فاینتیونینگ، مجموعهای جامع از راهکارها را برای یکپارچهسازی DeepSeek و دیگر مدلهای متنباز فراهم کرده است. این شرکت به عنوان یکی از بازیگران کلیدی در اکوسیستم متنباز، تاکنون صدها پروژه را تحت مجوزهای آزاد منتشر کرده و به طور مستمر بر بهینهسازی نرمافزارهای جامعه و مدلهای باز تمرکز دارد؛ رویکردی که امکان اشتراکگذاری گسترده دستاوردها را در حوزه ایمنی و تابآوری هوش مصنوعی فراهم میکند.
برای مطالعه بیشتر: ارزش بازار انویدیا از ۵ تریلیون دلار گذشت
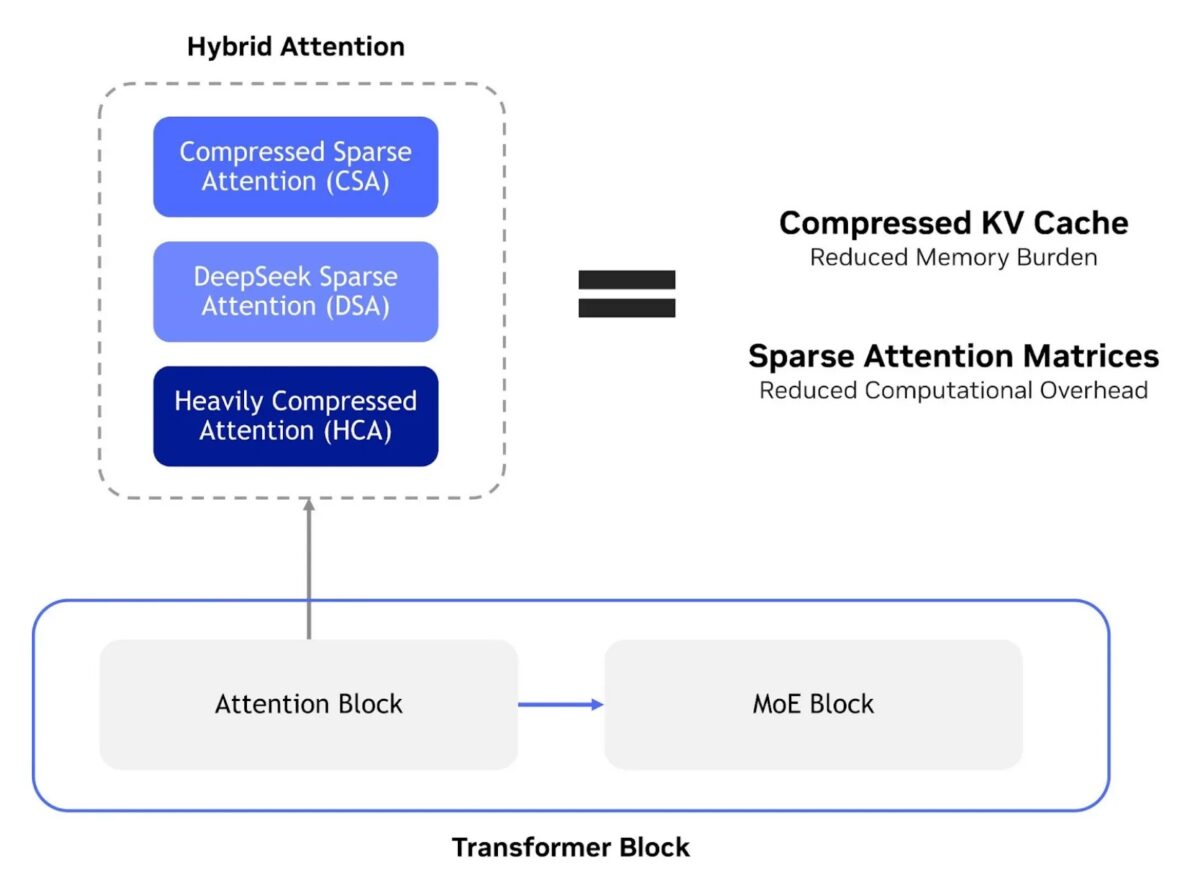
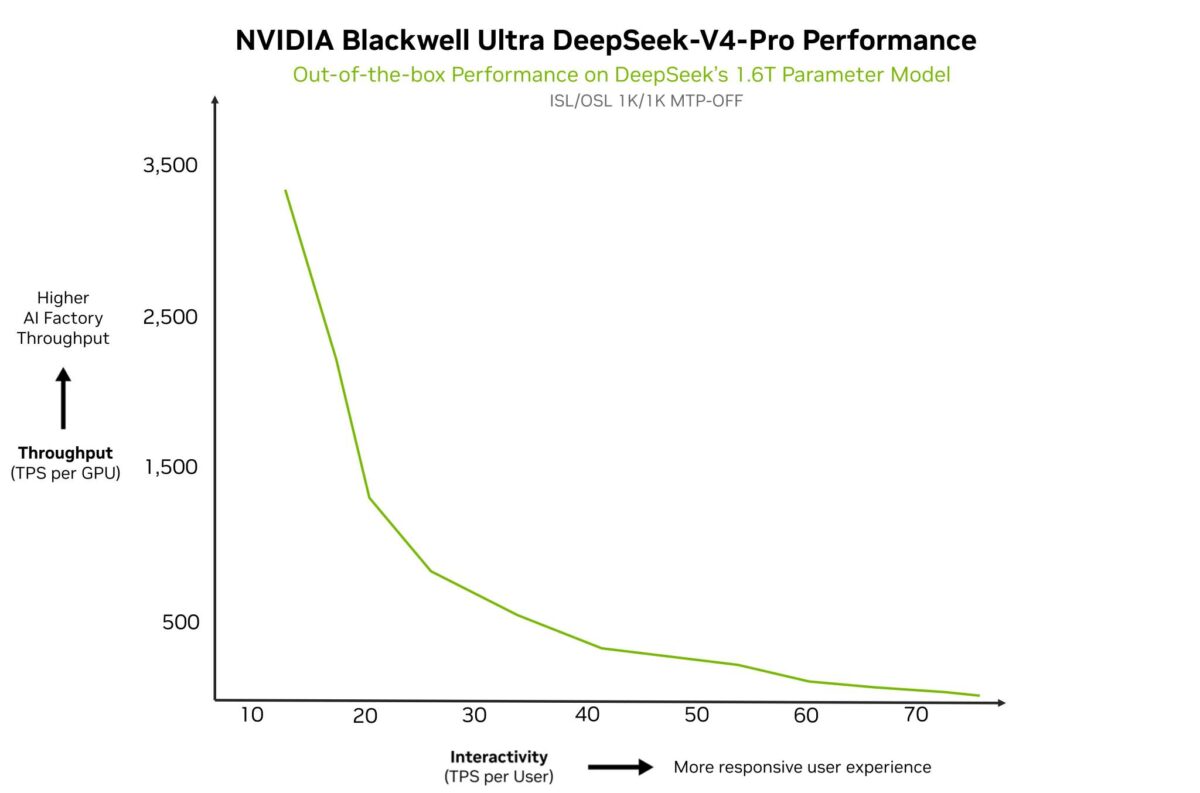
بر اساس دادههای ارائهشده توسط انویدیا، هر پردازنده گرافیکی از خانواده Blackwell (از جمله GB300 یا Blackwell Ultra) توان دستیابی به نرخ پردازش نزدیک به ۳۵۰۰ توکنبرثانیه را دارد. این ارقام در مرحله اولیه قرار دارند و با پیشرفت بهینهسازیهای لایه همطراحی (co-design stack)، انتظار میرود به طور قابلتوجهی افزایش یابند. پشته Blackwell نیز با مجموعهای از فناوریهای اختصاصی از جمله NVFP4، Dynamo، کرنلهای بهینهسازیشده CUDA و روشهای پیشرفته موازیسازی، به طور ویژه برای اجرای مدلهایی در مقیاس V4 طراحی شده است.
مرتبط: نقشه استراتژیک انویدیا برای کاهش زمان پاسخگویی مدل های هوش مصنوعی
در قلب پیشرفتهای DeepSeek-V4، استفاده از کمیسازی FP4 با استاندارد MXFP4 قرار دارد؛ رویکردی که با هدف تسریع در مراحل استنتاج و اجرای مدلها به کار گرفته شده است و با کاهش ترافیک حافظه و تاخیر نمونهبرداری، کارایی کلی را بهبود میبخشد. در همین حال، معرفی پشتیبانی از دستورالعملهای MXFP4 در نسل جدید شتابدهندههای Ascend هواوی (شامل مدلهای Ascend 950PR و Ascend 950DT که برای سال ۲۰۲۶ برنامهریزی شدهاند) نشان میدهد DeepSeek-V4 فراتر از اکوسیستم انویدیا با سختافزارهای بومی چین نیز سازگاری کامل خواهد داشت. در نهایت، با تداوم روند بهینهسازیها از سوی انویدیا، انتظار میرود که نسلهای آینده مدلها از همان ابتدا با پشتیبانی یک اکوسیستم بالغ و قدرتمند در دسترس توسعهدهندگان قرار گیرند.