یک نهاد تحقیقاتی وابسته به دولت ایالات متحده در جدیدترین ارزیابی خود از مقایسه پیشرفتهترین مدل هوش مصنوعی چین اعلام کرده است که این مدل حدود ۸ ماه از مرز فناوری مدلهای پیشروی جهانی عقبتر قرار دارد.
به گزارش سرویس هوش مصنوعی تکناک، طبق تحلیل این نهاد، این فاصله با گذر زمان در حال افزایش است. این گزارش بلافاصله با پرسشها و تردیدهایی درباره روششناسی ارزیابی مواجه شده است.
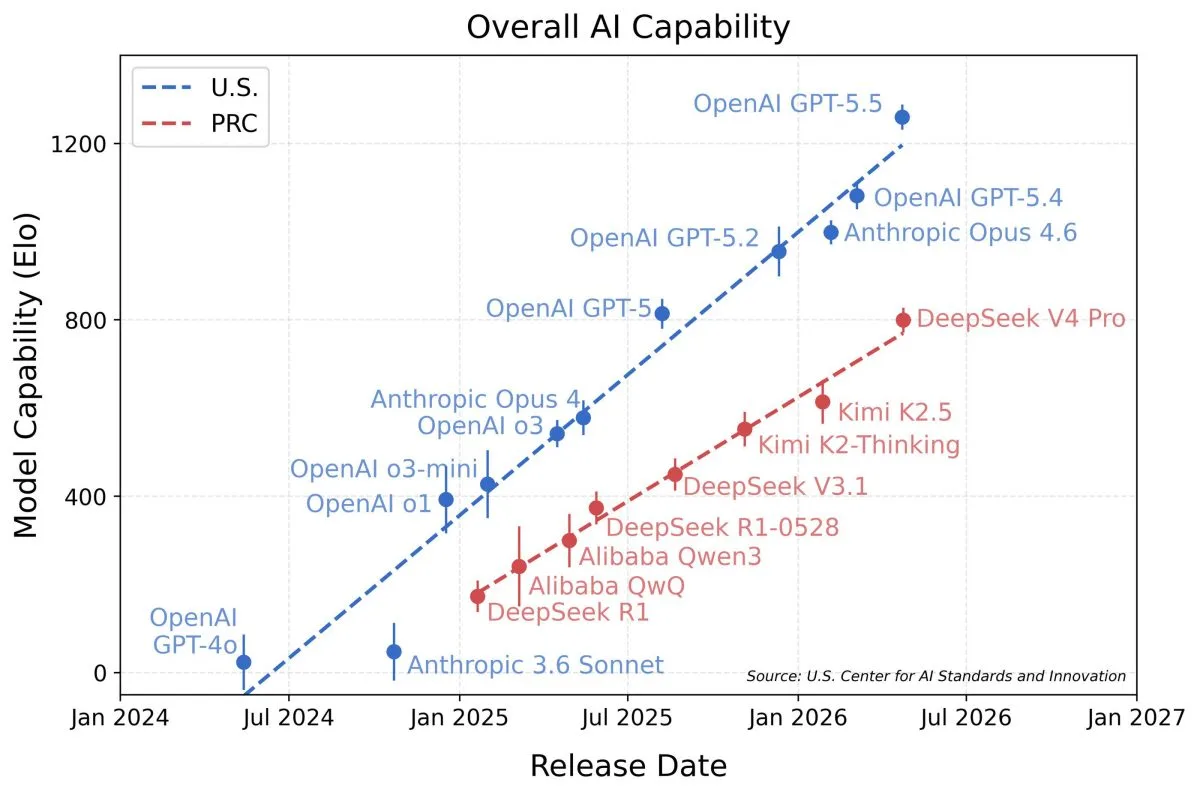
مرکز CAISI (Center for AI Standards and Innovation)، زیرمجموعه NIST، در تاریخ ۱ مه ارزیابی خود را از مدل DeepSeek V4 Pro منتشر کرد. جمعبندی این گزارش نشان میدهد که مدل متنباز پرچمدار دیپسیک در حدود ۸ ماه از مدلهای هوش مصنوعی آمریکا عقبتر است؛ هرچند همین نهاد آن را قدرتمندترین مدل چینی ارزیابیشده تا امروز معرفی کرده است. نکته متمایز در رویکرد CAISI، عدم استفاده از میانگین ساده بنچمارکها است. این نهاد به جای آن از روش “Item Response Theory (IRT)” استفاده میکند؛ یک چارچوب آماری برگرفته از آزمونهای استاندارد که توانایی پنهان مدل را از طریق الگوی موفقیت و شکست در حل مسائل مختلف تخمین میزند. این مقایسه هوش مصنوعی بر پایه ۹ بنچمارک در ۵ حوزه شامل امنیت سایبری، مهندسی نرمافزار، علوم طبیعی، استدلال انتزاعی و ریاضیات انجام شده است.
بیشتر بخوانید: تردید هوشمند؛ کلید جدید برای کاهش عدمقطعیت هوش مصنوعی
بر اساس محاسبات مبتنی بر IRT، امتیازهای Elo به این صورت گزارش شدهاند:
- GPT-5.5 با ۱۲۶۰ امتیاز
- Claude Opus 4.6 با ۹۹۹ امتیاز
- DeepSeek V4 Pro با حدود ۸۰۰ امتیاز (با عدمقطعیت ±۲۸)
این عدد آن را در سطح نزدیک به GPT-5.4 mini (با ۷۴۹ امتیاز) قرار میدهد. در این چارچوب، سیستم امتیازدهی مشابه آزمونهای استاندارد آموزشی عمل میکند؛ بهجای درصد پاسخ صحیح، وزندهی به نوع مسائل حلشده و حلنشده انجام میشود تا یک تخمین نسبی از توانایی مدلها ارائه شود. در نهایت، امتیاز بالاتر نشاندهنده عملکرد کلی بهتر است و مدل برتر به عنوان مرجع مقایسه سایر مدلها در نظر گرفته میشود.
نتایج منتشرشده از سوی CAISI به طور کامل قابل بازتولید مستقل نیست، چرا که دو مورد از ۹ بنچمارک مورد استفاده این نهاد عمومی نیستند و بیشترین شکاف عملکرد نیز دقیقا در همین بخشهای غیرشفاف مشاهده میشود. برای نمونه، در آزمون امنیت سایبری CTF-Archive-Diamond، مدل GPT-5.5 موفق به کسب ۷۱ درصد شده، در حالی که DeepSeek V4 Pro تنها حدود ۳۲ درصد امتیاز کسب کرده است.
با وجود این، در بنچمارکهای عمومی، تصویر پیچیدهتر و نزدیکتری به رقابت ارائه میشود. در GPQA-Diamond که سطح استدلال علمی در حد دکتری را میسنجد، دیپسیک با ۹۰ درصد عملکرد تنها یک درصد از Claude Opus 4.6 با ۹۱ درصد عقبتر است. در مجموعه آزمونهای ریاضی المپیادی شامل OTIS-AIME-2025، PUMaC 2024 و SMT 2025، این مدل بهترتیب ۹۷، ۹۶ و ۹۶ درصد امتیاز کسب کرده است. در SWE-Bench Verified (که توانایی رفع باگهای واقعی در GitHub را میسنجد) دیپسیک ۷۴ درصد و GPT-5.5 حدود ۸۱ درصد ثبت کردهاند. خود شرکت نیز ادعا کرده است که V4 Pro از نظر عملکرد کلی در سطح Claude Opus 4.6 و GPT-5.4 قرار میگیرد.
مرتبط: چین جایگزینی کارکنان شرکت ها با هوش مصنوعی را ممنوع کرد
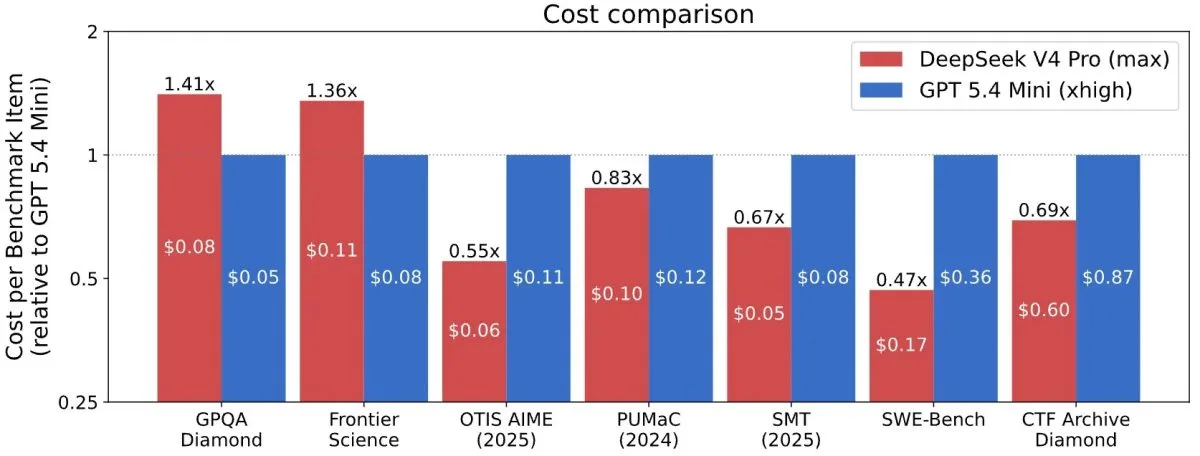
در بخش تحلیل هزینه، CAISI تنها مدلهایی را لحاظ کرده است که یا عملکرد ضعیفتری نسبت به دیپسیک داشتهاند یا هزینه استنتاج آنها به طور قابل توجهی بالاتر بوده است. در این فیلتر، تنها GPT-5.4 mini باقی مانده است؛ موضوعی که دامنه رقابت مدلهای آمریکایی را به حداقل رسانده است. از منظر هزینه-کارایی، دیپسیک در ۵ مورد از ۷ بنچمارک عملکرد بهتری نسبت به رقبا داشته و حتی از کوچکترین مدل OpenAI نیز مقرونبهصرفهتر ظاهر شده است. با وجود این مقایسه هوش مصنوعی، نقد روششناسی CAISI به تنهایی به معنای تایید کامل برتری دیپسیک نیست. توسعهدهندهای با نام مستعار Ex0bit در واکنشی صریح اعلام کرده است: «هیچ فاصله ۸ ماههای وجود ندارد و هیچ عقبماندگی واقعی در کار نیست؛ ما در برابر هر نسخه بسته آمریکایی آزمایش شدهایم و با مدلهای متنباز رقابت کردهایم.»
مرتبط: OpenAI مدل جنجالی GPT-4o را بازنشسته کرد
برای مطالعه بیشتر: مدل ارزانقیمت Grok 4.3 با ارتقا دقت پاسخدهی عرضه شد
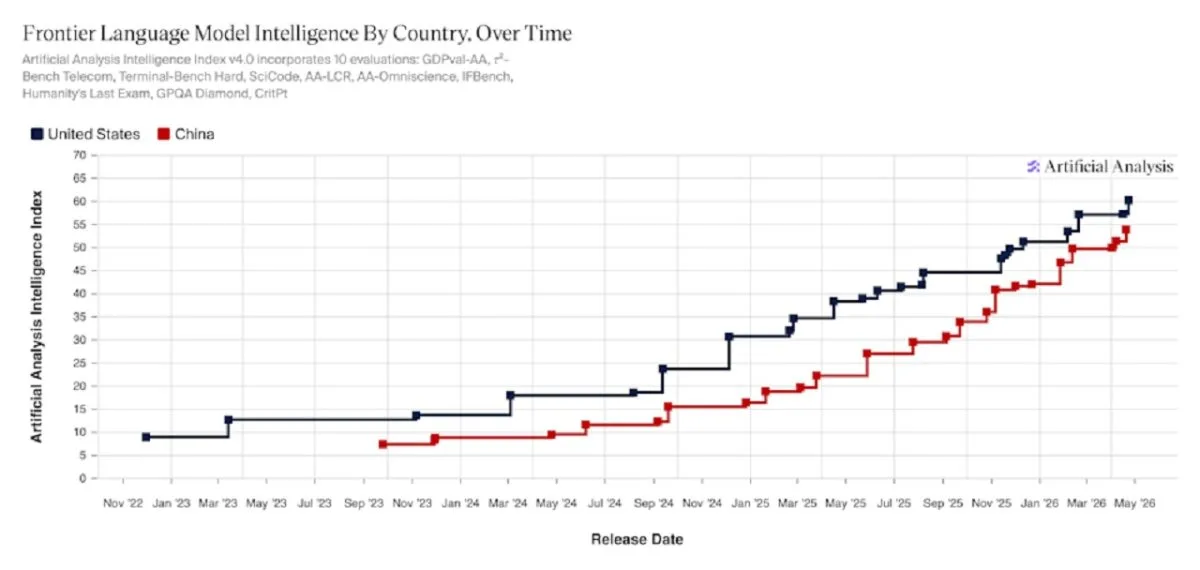
بر اساس شاخص Artificial Analysis Intelligence Index v4.0 که عملکرد مدلهای پیشروی هوش مصنوعی را در ۱۰ معیار مستقل مقایسه میکند، OpenAI در حدود ۶۰ امتیاز و دیپسیک در محدوده پایین ۵۰ امتیاز در مه ۲۰۲۶ قرار گرفتهاند؛ فاصلهای که نسبت به سال گذشته به طور قابل توجهی کاهش یافته است. این دادهها نشان میدهد که بر اساس بنچمارکهای استاندارد، شکاف عملکردی میان مدلهای پیشرو در حال کوچکتر شدن است. در زمان معرفی دیپسیک در ژانویه ۲۰۲۵، پرسش اصلی صنعت این بود که آیا چین توانسته است به آمریکا برسد یا خیر. در واکنش به این موج، آزمایشگاههای آمریکایی نیز سرعت توسعه خود را افزایش دادند. بر اساس گزارش AI Index دانشگاه استنفورد که در ۱۳ آوریل ۲۰۲۶ منتشر شد، فاصله در جدول Arena بین Claude Opus 4.6 و مدل چینی Dola-Seed-2.0 Preview اکنون به ۲.۷ درصد کاهش یافته است.