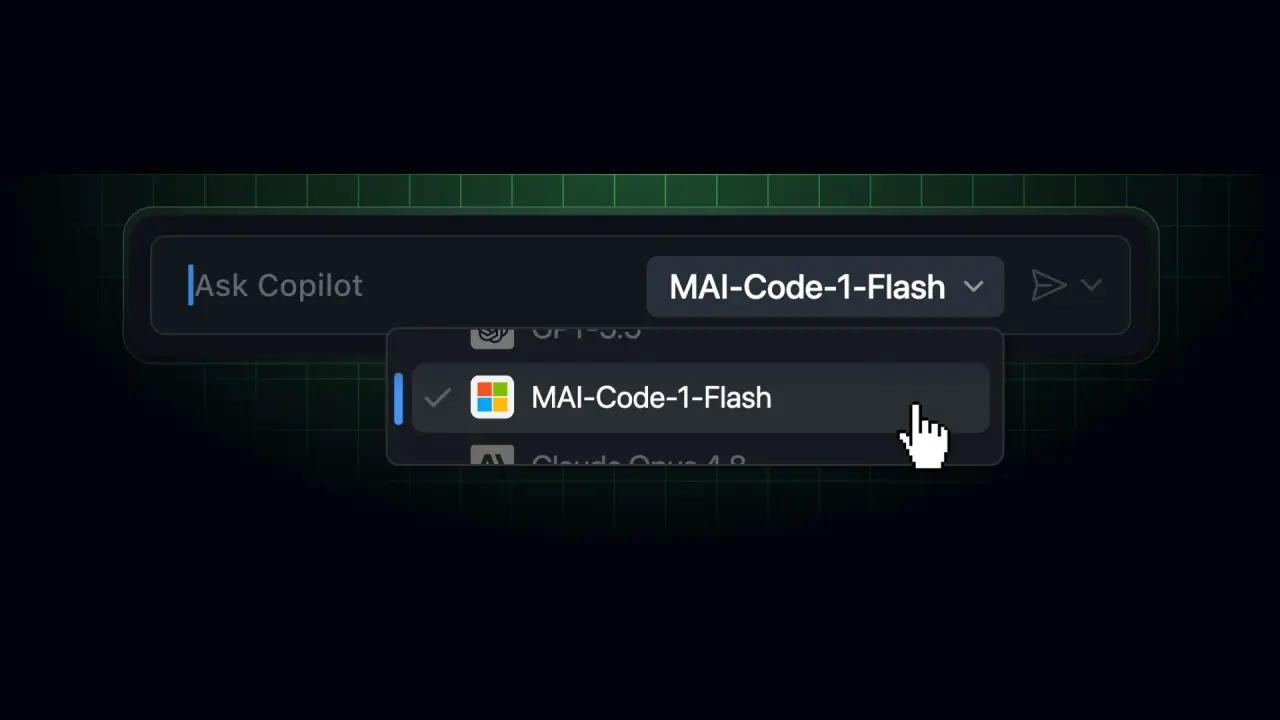
شرکت مایکروسافت مدل کدنویسی MAI-Code-1-Flash را به طور عمومی در اختیار مشتریان GitHub Copilot Business و Copilot Enterprise قرار داد.
به گزارش سرویس هوش مصنوعی تکناک، با اضافه شدن این پشتیبانی، سازمانها میتوانند کنترل متمرکزتری بر سیاستها و صورتحساب داشته باشند و در نهایت از مدل سبک و اختصاصی کدنویسی مایکروسافت استفاده کنند.
طبق اعلام گیتهاب، مدیران طرحهای Business و Enterprise باید ابتدا سیاست MAI-Code-1-Flash را در تنظیمات هوش مصنوعی کوپایلت فعال کنند تا توسعهدهندگان بتوانند به این مدل دسترسی داشته باشند.
شرکت مایکروسافت بیان کرد که مدل MAI-Code-1-Flash برای کارهای سریع و تکرارشونده کدنویسی طراحی شده است و برای سنگینترین وظایف معماری نرمافزار یا اشکالزدایی توسعه نیافته است. صفحه رسمی مقایسه مدلها در گیتهاب نیز اعلام کرده که این مدل برای «کدنویسی و نگارش عمومی» بسیار مناسب است و بهویژه در تکمیل سریع و دقیق کد، همچنین ارائه توضیحات، عملکرد بسیار خوبی دارد.
مرتبط: هوش مصنوعی چگونه ابزارهای کدنویسی را متحول کرد؟
شرکت مایکروسافت این مدل را در ۲ ژوئن به عنوان بخشی از مجموعه گستردهتری از مدلهای داخلی MAI معرفی کرد. گیتهاب بعدتر پشتیبانی از آن را به Copilot CLI، عامل ابری Copilot، چت GitHub.com، GitHub Mobile، ویژوال استودیو، محیطهای توسعه JetBrains، اکلیپس و Xcode گسترش داد، اما اعلام کرده بود که پشتیبانی از مشتریان مدیریتشده Business و Enterprise هنوز در راه است.
در آزمونهای بنچمارک داخلی مایکروسافت، MAI-Code-1-Flash در SWE-Bench Pro امتیاز ۵۱.۲ درصد را ثبت کرد، در حالی که Claude Haiku 4.5 از شرکت Anthropic امتیاز ۳۵.۲ درصد به دست آورده بود. همچنین مایکروسافت مدعی شده که این مدل در SWE-Bench Verified تا ۶۰ درصد توکن کمتری مصرف کرده است.
البته باید توجه داشت که این نتایج از سوی خود شرکت ارائه شدهاند و حاصل اندازهگیریهای مستقل نیستند.
مرتبط: آپدیت جدید فیگما مرز طراحی و کدنویسی را محو کرد
بر اساس گزارش نئووین، هزینه استفاده از این مدل در سیستم قیمتگذاری مبتنی بر مصرف گیتهاب، بر اساس فهرست قیمت ارائهدهنده محاسبه میشود. در حال حاضر گیتهاب مدل کدنویسی MAI-Code-1-Flash را با قیمت ۰.۷۵ دلار به ازای هر یک میلیون توکن ورودی، ۰.۰۷۵ دلار به ازای هر یک میلیون توکن ورودی کششده و ۴.۵۰ دلار به ازای هر یک میلیون توکن خروجی فهرست کرده است.
برای سازمانها، مهمترین انگیزه برای استفاده از MAI-Code-1-Flash به احتمال زیاد بهرهوری است و حداکثر توانمندی نیست. مدل کوچکتری که سریع پاسخ میدهد و خروجی غیرضروری را محدود میکند، برای وظایف تکراری عاملهای هوش مصنوعی در مقیاس بالا بسیار کاربردی است؛ بهویژه بعد از آنکه GitHub Copilot به سمت مدل صورتحساب مبتنی بر مصرف حرکت کرد.
مدل “Flash” برای کارهای سریع توصیه میشود و لزوما بهترین گزینه برای مخزنهای بسیار بزرگ با حجم بالای کانتکست نیست. بهتر است تیمها خروجی آن را با مدلهای بزرگتر دیگر مقایسه کنند، به خصوص زمانی که روی تغییرات حساس از نظر امنیتی یا پروژههای پیچیده و چندفایلی کار میکنند.